MiroFish 不是預言機:把多代理模擬做成可檢視的決策沙盒
MiroFish 將種子素材整理成知識圖譜,透過多代理人社群模擬生成情境報告。本文拆解其架構與快速開始步驟,並說明為何輸出應視為待驗證假設,而非可直接採信的預測。
MiroFish 不是預言機:把多代理模擬做成可檢視的決策沙盒
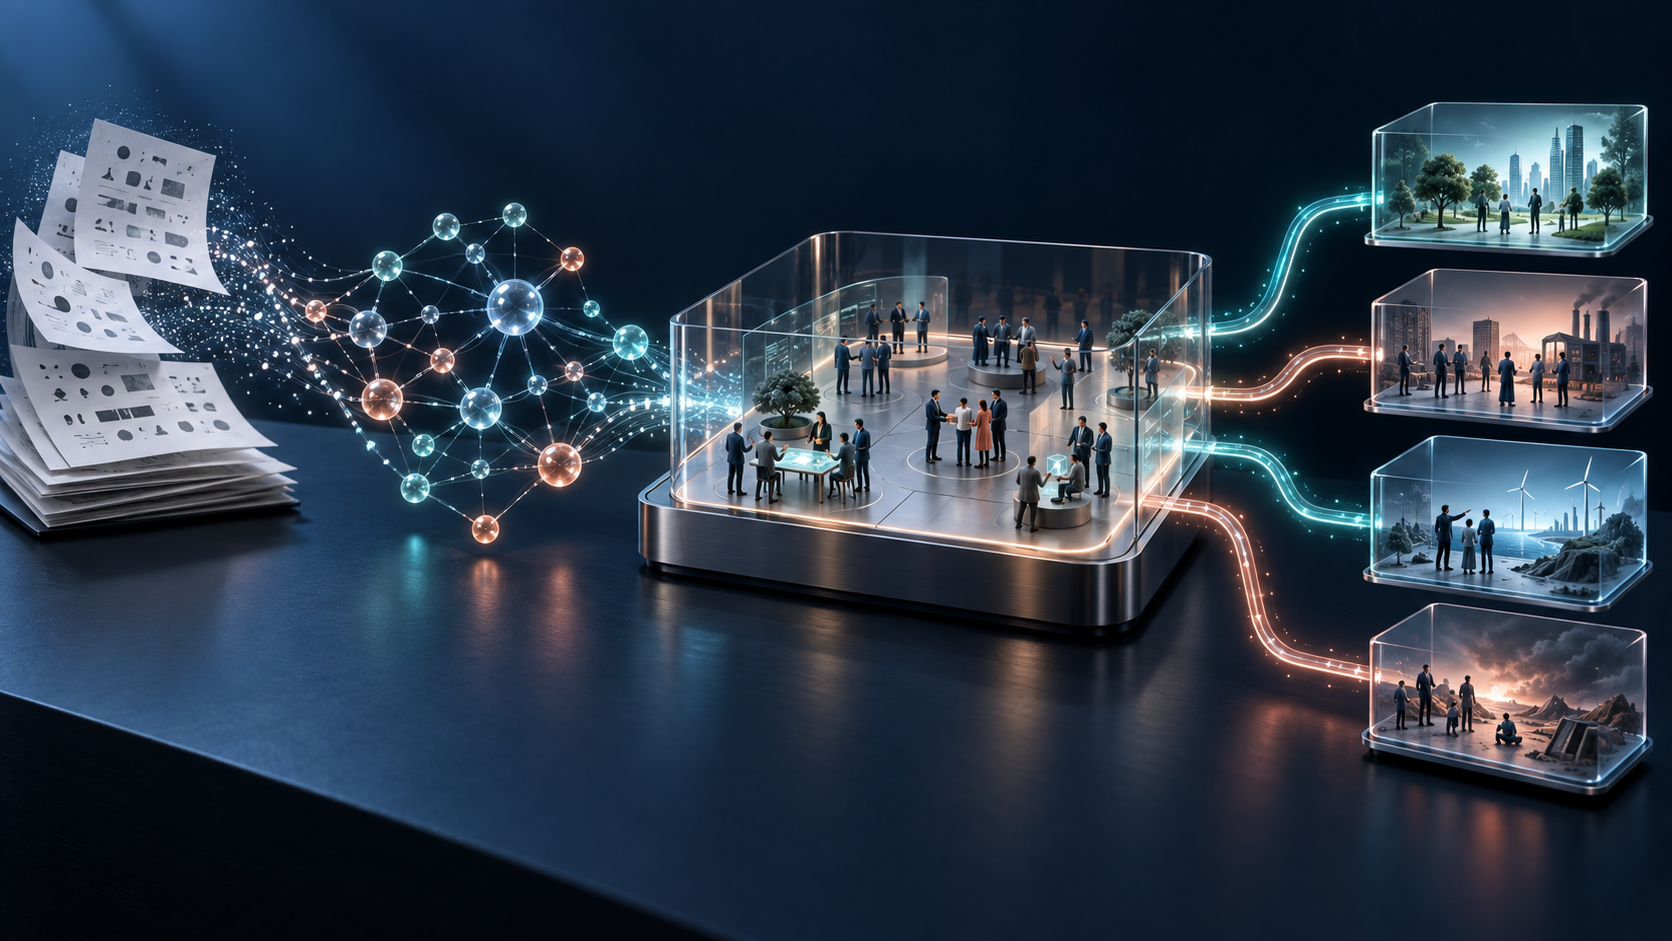
當團隊要推估一項政策、產品發布或輿情事件會怎麼發展,最常見的做法是找專家開會、做問卷,或拿過去資料建立模型。MiroFish 提出另一種路徑:先把一組現實素材轉成知識圖譜,再生成一批具不同設定的 AI 代理人,讓它們在模擬的社群環境中互動,最後整理出可能出現的情境與報告。
這個方向很吸引人,尤其當我們想問「如果改變一個條件,討論可能往哪裡走?」但我認為理解 MiroFish 的關鍵,不是把它當成能預知未來的系統,而是把它放在更務實的位置:一個可調整假設、觀察互動、比較情境的多代理決策沙盒。它能幫忙擴展討論,不能替真實世界背書。
先分清楚「預測」和「推演」
MiroFish 的 README 將它定位為預測引擎,並以新聞、政策草案、金融訊號等素材作為輸入。依照官方流程,系統會抽取素材中的人物與關係,建立圖譜,產生代理人設定,再讓代理人在類似 Twitter、Reddit 的環境中互動,最後由 ReportAgent 整理結果。使用者也能在模擬後與代理人或報告代理互動。
這套流程真正擅長回答的,是「在這組輸入、這些角色設定與這套互動規則之下,會長出哪些可能的討論路徑?」它並沒有因為代理人數量很多,就自動變成對真實人群的抽樣調查;也沒有因為報告寫得完整,就自動證明某個情境會發生。
這是「推演」和「預測」之間的重要界線。可靠的預測通常還需要明確的評估資料、基準模型、誤差指標,以及對不同事件反覆驗證的紀錄。就我查閱的 MiroFish 官方 README、快速開始文件與程式入口而言,沒有看到可重複的預測準確率基準。因此,在缺少驗證前,模擬輸出應被視為待檢查的假設,而不是決策結論。
MiroFish 的工作流程,拆成四個環節
1. 從素材建立圖譜
使用者先提供種子材料與想回答的問題。MiroFish 的圖譜服務會把文字交給 Zep Cloud,建立節點與關係;程式中的 GraphBuilderService 也明確以 Zep API 建立 standalone graph。這一步的作用,是讓後續代理人設定有一份可查詢的背景脈絡,而不只是從一段提示詞憑空開始。
素材品質會直接影響後面的推演。如果材料只呈現單一立場、缺少關鍵角色,或把未證實的說法當成事實,圖譜與代理人設定就可能把這些偏差一路帶進模擬。換句話說,圖譜不是事實查核器;它整理的是輸入內容,不會自動替輸入補上可靠性。
2. 由模型生成模擬設定與代理人
接著,MiroFish 會依照模擬需求、文件內容與圖譜實體,生成時間設定、事件設定以及一批代理人設定。官方程式把這些設定拆成不同階段處理,代理人設定也會分批產生。每個代理人的個人資料、背景描述與行為設定,都是模擬的初始條件之一。
這表示結果不只取決於「有多少代理人」,也取決於系統如何從材料抽出角色、如何描述角色,以及模型如何依照設定產生行動。若某個重要立場沒有進入素材,增加代理人數量也不會神奇地補出具代表性的真實民意。
3. 在 OASIS 社群環境中執行互動
MiroFish 使用 CAMEL-AI 的 OASIS 作為模擬引擎。OASIS 專案本身是開源的社群互動模擬器,README 說明其環境涵蓋 Twitter 與 Reddit 類型的平台互動,代理人可以追蹤、留言、轉貼等。MiroFish 的執行程式則可選擇 Twitter、Reddit 或平行模式;是否啟用圖譜記憶更新也有獨立參數,而且程式中的預設值是關閉。
這些設計讓模擬不只是一次性的文字問答:代理人會在平台規則與事件設定下反覆採取行動,系統記錄互動,再將結果提供給後續報告與探索。值得注意的是,OASIS README 提到的規模能力屬於上游引擎的說明,不能直接當成 MiroFish 在任意硬體、任意模型或任意設定下都能達到的效能保證。
4. 產生報告,再回到互動探索
模擬結束後,ReportAgent 會根據模擬環境整理報告;使用者也能進一步與報告代理或特定代理人對話。這個互動介面很適合追問「這個情境為什麼出現?」或「某個角色遇到不同資訊時可能怎麼反應?」
但要記得,對代理人的追問仍然是在同一個合成環境裡進行。它可以幫助我們解釋模型內部發生了什麼,不能把代理人的回答當成真實受訪者證詞,也不能拿來取代外部查證。
哪些情境適合拿它來試
我會優先把 MiroFish 用在「產生值得查證的情境」而非「替人做最後決策」。例如,公關團隊可用一份已查證的事件資料,探索不同回應方式可能引發哪些討論分支;產品團隊可以比較兩種功能發布說明,找出使用者可能誤解的地方;研究或創作團隊則可以用角色與背景設定,探索故事情節或社群互動的可能走向。
好的問題通常範圍清楚、條件可變,也能指出哪些結果需要外部驗證。例如:「如果公告延後一週,哪些利害關係人可能改變立場?」比「預測這家公司未來會怎樣」更適合作為第一個實驗。前者可以拆成可比較的條件;後者太廣,容易讓輸出看起來完整,卻很難判斷是否真的有用。
如何開始:先跑一個小規模情境
MiroFish 官方快速開始提供原始碼與 Docker 兩種部署方式。原始碼路徑需要 Node.js 18 以上、Python 3.11 至 3.12,以及 uv。系統還需要一個相容 OpenAI SDK 格式的 LLM API,以及 Zep Cloud 帳戶。環境變數範例包含 LLM_API_KEY、LLM_BASE_URL、LLM_MODEL_NAME 與 ZEP_API_KEY;請把實際憑證留在本機 .env,不要貼進程式碼、Issue 或公開日誌。
git clone https://github.com/666ghj/MiroFish.git
cd MiroFish
cp .env.example .env
編輯本機 .env,填入模型服務與 Zep Cloud 的必要設定後,再安裝前後端依賴並啟動:
npm run setup:all
npm run dev
依照 README,前端預設在 http://localhost:3000,後端 API 預設在 http://localhost:5001。若啟動失敗,先分別確認 Node.js、Python 與 uv 版本,再檢查 .env 是否填妥、模型服務的 LLM_BASE_URL 是否可連線,以及 Zep Cloud 憑證是否有效。第一次測試不要直接餵入大量文件或設定很多輪:官方 README 提醒模擬消耗可能偏高,並建議先從少於 40 輪的設定開始。這是專案提供的使用建議,不代表所有模型、素材與場景的成本都相同。
我的建議是先用一份短而可查證的材料,寫下一個具體問題,固定代理人規模與其他設定,只改一個條件,觀察報告是否真的呈現出可比較的差異。把原始素材、模型名稱、模擬輪數、角色設定與輸出都記錄下來,之後再用訪談、問卷、歷史案例或專家檢視去驗證。若每次更換提示詞、角色數與事件設定,結果就很難知道是哪個變因造成的。
把一次模擬做成可回顧的小實驗
如果我想用 MiroFish 探索一項公告的反應,不會只輸入「大家會怎麼想?」然後把生成報告當答案。我會先寫下決策問題,例如「先公布完整時程,或先發布原則說明,哪一種更容易引發對交付日期的誤解?」接著準備一份相同的背景材料,確認關鍵角色與事件都在其中,再把兩種公告方式設為不同情境。
比較時一次只改一個主要條件。基準組與變化組盡量沿用相同的材料、代理人規模、模擬輪數與模型設定,並保存每次使用的文件版本、問題描述、設定、執行時間及輸出。若同一組設定重跑後出現不同走向,也把差異留下來,而不是只挑最符合預期的一次。這些紀錄能讓團隊回頭檢查:結論是由哪個輸入或設定推動,還是只是一段讀起來很有說服力的敘事。
閱讀報告時,我會把「模擬中實際發生的行為」、「代理人或報告代理對行為的解釋」,以及「團隊因此提出的現實世界假設」分開記錄。三者不是同一種證據。接下來再挑出最重要的兩三個假設,用過去事件、使用者訪談、專家檢視或小規模實驗來驗證。若外部資料不支持模擬結果,就應修正假設,而不是為了保住報告而替結果找理由。
這種做法不會讓模擬突然變成經過校準的預測模型,但能讓它成為有邊界、有紀錄、可以被反駁的探索流程。對團隊而言,這往往比追求一份看似完整的「未來答案」更有實際價值。
導入前要看見的限制
第一,代理人不是人口統計樣本。 代理人是依照素材與模型生成的角色,不等同於從真實使用者中隨機抽樣。若要研究輿情或市場反應,仍要用真實調查、客服資料或其他外部證據交叉比對。
第二,初始材料會形成錨點。 圖譜與角色設定建立在種子材料上;材料的選擇、缺漏與描述方式都可能影響推演方向。開始前應列出資料來源、時間範圍、尚未確認的主張,以及刻意納入的不同立場。
第三,成本與資料邊界需要先盤點。 這個流程依賴外部 LLM API 與 Zep Cloud,模型呼叫、代理人數、互動輪數和報告長度都可能影響耗用。自行架設前端或後端,不代表整條資料處理路徑都是離線;敏感材料必須先確認是否允許送往外部服務,也要先估算 API 費用與資料保留政策。
第四,授權要配合部署方式確認。 GitHub 專案 metadata 標示 AGPL-3.0。若要修改程式、對外提供服務或納入商業產品,應先閱讀專案授權全文,確認適用義務;不要只看「開源」兩個字就假設沒有條件。
因此,我不會把 MiroFish 用來直接決定投資、醫療、公共政策或其他高風險選擇,也不會把模擬報告包裝成民意預測。比較合適的做法,是將它當作一個假設生成器:先讓它提出可能情境,再由人回到資料、專家與現場驗證,最後才決定哪些情境值得採取行動。
結語:把它當成模擬室,而不是水晶球
MiroFish 的亮點,是把知識圖譜、代理人設定、社群互動與報告探索串成一條可操作的流程。對需要快速展開「如果……會怎樣?」討論的團隊來說,這比單輪聊天更有結構,也能留下可追問的模擬脈絡。
然而,模擬的細節再豐富,也不會自動變成真實世界的證據。若把它放在「提出假設、比較情境、找出下一步要查什麼」的位置,它值得小規模試用;若期待它直接告訴我們未來會發生什麼,就超出了目前公開證據能支持的範圍。把 MiroFish 當成模擬室,而不是水晶球,才是比較穩健的使用方式。
參考資料