RAG 不一定要向量資料庫:PageIndex 如何讓模型沿著文件樹找答案
多數 RAG 系統把文件切成固定片段,再用向量相似度找上下文;PageIndex 改用階層式文件樹與 LLM 推理來定位內容。本文從架構、上手流程、成本與限制拆解這個 vectorless RAG 引擎,說明它適合哪些長篇專業文件,以及為什麼它不是所有場景的向量資料庫替代品。
RAG 不一定要向量資料庫:PageIndex 如何讓模型沿著文件樹找答案
我認為,RAG 系統最容易被忽略的問題,不是模型夠不夠大,而是「它到底怎麼找到這段內容」。典型做法是把文件切成固定大小的 chunks,替每個 chunk 建立 embedding,再用向量相似度找出幾段看起來相近的文字。這條路徑成熟、容易理解,也很適合大量短文本;但當資料變成年度報告、法規、技術手冊或研究論文時,固定切片常常會把上下文拆散。
PageIndex 是 VectifyAI 開源的文件索引與推理式 RAG 專案。它的核心主張不是再做一個更快的向量搜尋,而是把文件轉成階層式 tree index,讓 LLM 像人閱讀長文件一樣,沿著章節與子章節逐步判斷應該查看哪裡。這個方向值得注意,但也不能被簡化成「向量資料庫已經過時」:PageIndex 官方 README 明確把它定位成研究性、reasoning based 的 vectorless RAG 引擎,實際是否適合,仍取決於文件結構、查詢型態、模型成本與可接受的延遲。
先講結論:它解決的是「相關」不等於「相似」
向量 RAG 的優點是效率與規模。文件被轉成向量之後,查詢可以快速找到語意相近的片段;對 FAQ、客服紀錄、產品描述與大量短文件,這通常是很實用的基線。不過,相似度只回答「這段文字和問題像不像」,不一定回答「這段文字在整份文件的脈絡中是不是正確答案」。
例如,使用者問一份財報「某年度營業利益率是多少,以及這個數字在管理層討論中如何解釋」。答案可能分散在財務表格、註解與管理層評論。單獨看某個 chunk,數字也許相似,但缺少章節關係、表格標題或前後文,就容易得到看似合理卻不完整的回答。
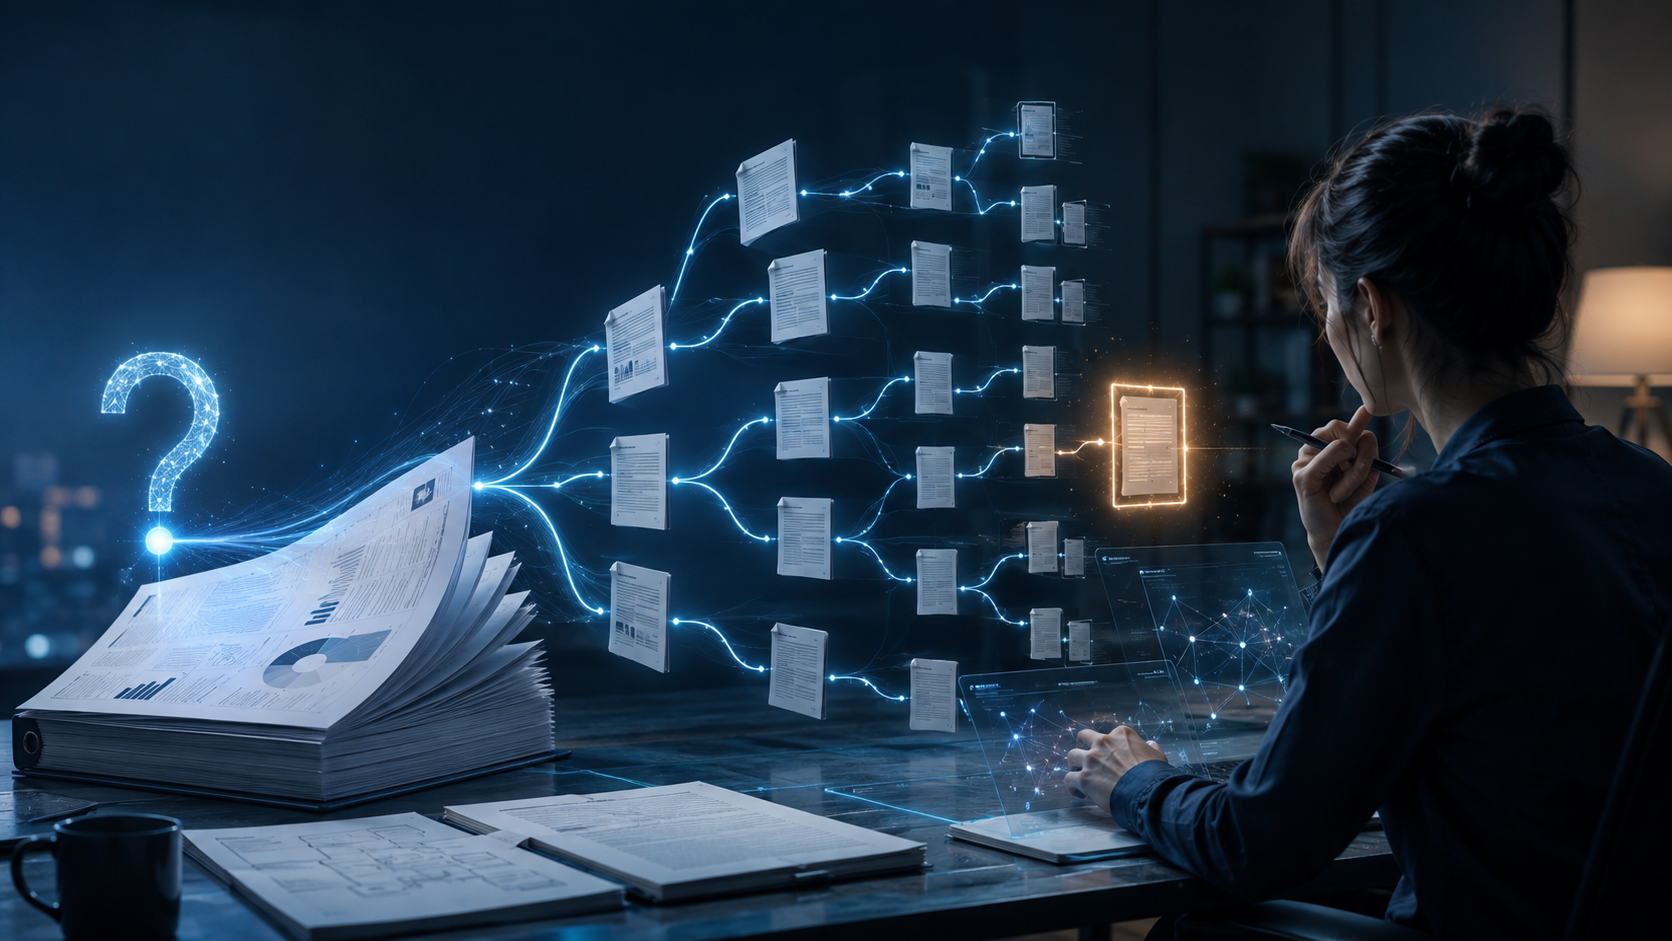
PageIndex 的做法是先建立文件的階層結構,再讓模型在這棵樹上進行檢索。官方說明把流程拆成兩步:第一步是 index,從文件產生 tree structure index;第二步是 retrieve,讓 agent 透過 LLM reasoning 搜尋這棵樹。這帶來一個重要差異:檢索單位不再是任意長度的文字片段,而是文件原本具有語義的章節、節點與頁面範圍。
我會把它理解成「把文件目錄變成可推理的導航圖」。模型不是只問哪一段文字最像,而是先判斷問題應該落在哪個主題分支,再往下縮小範圍,最後回到可追溯的頁面或節點。這也是 PageIndex 強調 traceable 與 explainable retrieval 的原因。
PageIndex 的架構,和一般 RAG 差在哪裡
1. Index:先建立階層式文件樹
PageIndex 不是把全文直接丟給聊天模型。它先分析文件的版面與結構,產生一個代表章節關係的樹。對有清楚目錄、章節標題、頁碼與段落層次的 PDF,這種索引方式可以保留「內容位於哪個脈絡」這個資訊。
這和固定 chunking 的差別很實際。chunking 往往需要決定片段大小、overlap、分隔符號與 metadata;切得太小,答案被拆碎;切得太大,檢索精準度與上下文成本又會上升。PageIndex 的官方定位是 no vector DB, no chunking,但這不表示它不需要任何資料轉換,而是把前處理重心從「切成可嵌入的片段」移到「建立可導航的文件結構」。
2. Retrieve:沿著樹做推理式搜尋
查詢進來後,模型會在樹上選擇可能相關的分支,逐步讀取節點,再把結果連回文件中的具體位置。當問題涉及多個章節或需要理解上下文時,這種 agentic search 有機會比只取相似 chunk 更自然。
但這裡也有一個工程上的交換:推理式檢索通常需要更多模型呼叫,延遲不會自動低於向量搜尋。PageIndex 的價值不是承諾每次查詢都更快,而是把檢索判斷本身做得更接近長文件閱讀。團隊在評估時,應該同時測量答案正確性、引用可追溯性、每次查詢成本與 P95 延遲,而不是只看 demo 是否能回答一個問題。
3. Chat:把檢索結果交給問答介面
SDK 將索引與查詢包裝成 client。README 的 quickstart 示範了建立 PageIndexClient、提交 report.pdf、取得 doc_id,再以 client.chat 提問。這表示它不只是一組離線索引工具,也試圖提供從文件送入到對話查詢的完整入口。
更重要的是,PageIndex 的文件還列出 streaming、多文件搜尋、citations,以及把 PageIndex tools 整合進 OpenAI Agents SDK、Claude Agent SDK 或其他 agent framework 的方向。對已有 agent 平台的團隊來說,它比較像一個可插入的文件推理工具,而不是要求整個應用程式改寫成單一產品。
如何開始:先用一份文件驗證,不要直接索引整個知識庫
我建議把 PageIndex 當成一個需要驗證的檢索策略,而不是安裝後立刻替換現有 RAG。官方 quickstart 的最小流程可以整理成以下幾步。
第一步:準備 Python 環境與模型存取
官方 README 以 PyPI 套件作為入口:
pip install -U pageindex接著要準備可呼叫的 LLM API key,並選擇建立索引與進行查詢的模型。索引模型主要負責建立或整理樹狀結構;聊天模型負責理解問題、搜尋樹並產生答案。官方建議索引模型可以使用較基本的模型,而查詢模型應優先選擇能力較好的模型,因為後者直接影響推理式檢索品質。
這裡的重點不是照抄某個模型名稱,而是把兩種成本拆開看。索引通常是一次性或低頻工作,查詢則可能是每天數千次的線上工作。把最強模型只用在需要推理的查詢階段,通常比所有步驟都使用同一個昂貴模型更容易控制預算。
第二步:建立 client 並提交一份 PDF
以下是官方 quickstart 的概念性入口,實際模型名稱與 provider 設定應以目前文件為準:
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="index-model",
    chat="chat-model",
)
doc_id = client.submit_document("report.pdf")["doc_id"]

answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
在正式環境中,不要把真正的 key 寫死在程式碼或 commit 裡;應使用環境變數、secret manager 或部署平台的 secrets。提交文件後,先確認是否取得有效的 doc_id,再執行一個能對照原始 PDF 的問題。第一個測試最好不是開放式問題,而是答案位置明確、可以人工核對的數字、日期、條款或章節。
第三步:建立小型評測集
不要只問一題就下結論。我會從目標文件挑選十到二十個問題,分成三類:單一章節可以回答的問題、需要跨章節連結的問題,以及刻意測試相似但不相關內容的問題。每題記錄標準答案、正確頁面、是否需要引用、回答耗時與模型用量。
接著拿同一批問題跑現有的 vector RAG 與 PageIndex。評估結果至少要分開看:
- 找到正確內容的比例,而不是只看文字相似度。
- 回答是否保留必要的上下文與條件。
- 引用是否能回到正確頁面或節點。
- 索引的初始成本,以及每次查詢的 token 與延遲。
- 文件更新後,重建索引是否容易、是否會影響線上服務。
這個評測流程比單一 benchmark 數字更接近導入決策,因為企業文件的版面、語言、表格與權限邏輯往往和公開資料不同。
為什麼長篇專業文件特別適合拿來測試
PageIndex 的定位很清楚:金融報告、法律文件、監管申報、技術手冊、醫學文獻與學術教科書等長而複雜的專業文件,是它最有機會展現差異的場景。這些文件通常具有可利用的階層結構,同一個名詞又可能在不同章節扮演不同角色。
以法規為例,問題可能不是「哪一段提到某個詞」,而是「在什麼條件下,哪個例外條款優先適用」。以技術手冊為例,某個參數的意義可能要和版本、平台、前置設定一起解讀。如果只從相似度取回幾段片段,模型還要自己猜這些段落在文件中的關係;如果索引保留了目錄和節點脈絡,模型至少多了一條可推理的導航路徑。
不過,文件有結構不等於結構一定正確。掃描品質差、目錄缺失、表格解析錯誤、跨頁欄位或大量圖片,都可能讓樹索引建立在不可靠的基礎上。因此導入前應先抽樣檢查樹狀索引,不能把「有 tree」當成「理解了文件」。
成本、限制與容易誤判的地方
它不是所有 RAG 的替代品
短文本、高頻查詢、需要毫秒級回應,或資料本身沒有穩定階層結構時,向量索引仍然可能是更直接的選擇。PageIndex 的推理式搜尋引入了模型呼叫,查詢成本和延遲都應該納入設計。更合理的架構可能是混合策略:先用 metadata 或關鍵字做粗篩,再對少數長文件使用 tree reasoning,而不是全站每個查詢都走同一條路。
索引費用不是零
官方 README 提供了本地索引成本與時間的估算,並提醒使用者先閱讀文件、從小規模開始。即使一次索引的成本可以接受,企業仍要計入文件更新頻率、重建策略、模型價格變動、失敗重試與儲存成本。尤其是每天變動的資料,若每次更新都要重建完整樹,整體成本可能和原本的 embedding pipeline 不同。
推理能力不等於事實正確
PageIndex 強調 reasoning-based retrieval,但模型沿著錯誤分支推理時,仍可能產生幻覺或引用錯誤。檢索可追溯性可以幫助審查,卻不會自動取代資料治理、權限控管、版本管理與人工抽查。金融、法律、醫療等高風險情境,應要求答案附來源並設計拒答與人工覆核流程。
版本與 API 需要固定驗證
開源 SDK 會持續演進。PageIndex 目前的 README 也提醒,local mode、Cloud、PageIndex Flash、多文件與 agent 整合等能力會隨版本更新。文章中的安裝命令只能作為起點,團隊在導入時應鎖定套件版本,閱讀對應版本文件,並在 CI 中驗證索引輸出與查詢結果,不要直接假設最新版本和舊 quickstart 完全相同。
隱私與資料邊界要先談清楚
如果文件包含個資、商業機密或受規範資料,首先要確認索引與查詢會把哪些內容送到哪個模型 provider。local mode 可以讓索引、檢索與聊天在本機執行,但「本機執行」不代表所有模型都在本機;只要使用外部 LLM API,就要重新檢查資料傳輸、保留期限與供應商條款。這一點比選擇 vector 或 tree 更基本,也更不能省略。
我會如何決定是否導入
我的判斷順序會是先看文件,再看技術。若資料是大量短句、標準問答與明確 metadata,先把傳統 vector RAG 做好,通常比較划算。若資料是數百頁以上的專業文件,問題需要跨章節理解,且團隊在意引用能否回到原始位置,PageIndex 就值得進入 A B test。
第二個判斷是「錯誤的代價」。如果錯誤只會讓使用者多點一次搜尋,較高的推理成本可能換來更好的體驗;如果錯誤會造成合約、財務或醫療決策,則不能只用 demo 成功率判定,必須加上引用檢查、權限、審批與 fallback。
第三個判斷是團隊能否維護評測。無論採用哪種 RAG,沒有固定問題集、版本紀錄和成本監控,最後都只是在憑感覺換元件。PageIndex 的真正價值,應該透過與既有方案的同資料、同問題、同模型條件比較來證明,而不是因為「不用向量資料庫」這句話聽起來新鮮就直接上線。
結語:把檢索從相似度問題,重新變成閱讀問題
PageIndex 提供了一個值得實驗的觀點:長文件問答的瓶頸,有時不是 embedding 不夠好,而是系統沒有保留文件原本的結構。用階層式樹索引搭配 LLM 推理,讓檢索更像人從目錄找到章節,再回到頁面確認內容。這種設計特別適合結構清楚、篇幅很長、需要上下文與來源追蹤的專業文件。
我的建議不是全面拋棄向量 RAG,而是把 PageIndex 放到正確的位置:先挑一批高價值長文件,建立可核對的評測集,再比較答案品質、引用、成本、延遲與更新維護。若結果證明 tree reasoning 能降低關鍵錯誤,再用混合架構擴大;若文件結構不穩定或查詢量太高,傳統方法可能仍是更好的工程選擇。
參考資料