AI 工具指南 Hindsight RAG AI Agent 為何每次都要重學?從 Hindsight 看長期記憶怎麼設計 對話歷史與 RAG 各有擅長的問題,卻不一定能讓 Agent 跨工作階段整理偏好、事件與新證據。本文以 Hindsight 的 retain、recall、reflect 流程為例,說明長期記憶的設計方式、上手步驟與部署前必須面對的治理成本。 2026年9月26日 閱讀更多
AI 應用 Crawl4AI RAG 把網頁變成可用上下文:Crawl4AI 如何用 Markdown、瀏覽器控制與安全邊界打造 LLM-ready 爬蟲 Crawl4AI 將動態網頁轉成適合 LLM、RAG 與資料管線使用的 Markdown 與結構化資料。本文從非同步爬取、內容降噪、深度爬取到 Docker server 的安全邊界,拆解如何把一次性抓取腳本導入成可觀測、可重跑的來源擷取層。 2026年9月16日 閱讀更多
企業知識庫 PageIndex RAG RAG 不一定要向量資料庫:PageIndex 如何讓模型沿著文件樹找答案 多數 RAG 系統把文件切成固定片段,再用向量相似度找上下文;PageIndex 改用階層式文件樹與 LLM 推理來定位內容。本文從架構、上手流程、成本與限制拆解這個 vectorless RAG 引擎,說明它適合哪些長篇專業文件,以及為什麼它不是所有場景的向量資料庫替代品。 2026年9月4日 閱讀更多
AI 工具指南 Milvus RAG 別讓 RAG 卡在檢索層:Milvus 如何把向量搜尋做成可擴展的 AI 基礎設施 RAG 的瓶頸常常不在模型,而在檢索層是否能從本機原型一路長到生產規模。本文用 Milvus 的官方架構與 quickstart 拆解向量搜尋、metadata filtering、hybrid search,以及從 Milvus Lite 走向 Docker 與 Kubernetes 的實務路線。 2026年8月31日 閱讀更多
企業知識庫 LightRAG RAG LightRAG:把知識圖譜與向量檢索整合進 RAG 的實作指南 LightRAG 將知識圖譜、向量 embeddings 與多種查詢模式整合進同一個 RAG 工作流。本文從雙層索引、文件解析、部署安全到成本評估,整理一條可實作的導入路徑。 2026年8月30日 閱讀更多
AI 工具指南 Meilisearch RAG Meilisearch 不只是搜尋框:用 Hybrid Search 把 RAG 的檢索層做成可維護服務 Meilisearch 把全文搜尋、語意搜尋、Hybrid Search 與 conversational search 放進同一個 API 導向的搜尋引擎。本文從 Docker 上手、embedding pipeline、權限與評估方法出發,拆解它如何成為 AI 應用可維護的檢索層,也說明哪些情況不適合直接採用。 2026年8月25日 閱讀更多
企業知識庫 LlamaIndex RAG LlamaIndex 不只是 RAG:把私有資料接上 Agent 的實作框架 很多團隊已經會呼叫 LLM,卻仍卡在文件解析、資料切分、檢索、引用與 Agent 工作流程。LlamaIndex 把資料連接器、索引、Retriever、Query Engine 與 Workflow 放進同一個 Python 生態,讓私有資料真正成為可被 Agent 使用的上下文。本文從官方文件出發,拆解它的定位、上手方式、適用情境與不能忽略的限制。 2026年8月24日 閱讀更多
AI 工具指南 MemPalace RAG 讓 AI 記住但不把資料送上雲端:MemPalace 的 local-first 記憶系統拆解 AI Agent 的上下文視窗會重置,但團隊決策、程式碼脈絡與對話不該跟著消失。本文從 MemPalace 的 verbatim 儲存、分層檢索、可插拔後端與 MCP 整合出發,實際拆解如何在本機建立可搜尋、可恢復的 AI 記憶層,也整理安裝版本、非互動初始化、模型下載與資料權限等容易踩坑的細節。 2026年8月22日 閱讀更多
開發者工具 RAG 開源 從 RAG 到 Agent:Haystack 3.0 如何把 LLM 應用拆成可追蹤的 Pipeline Haystack 3.0 以 component 與 Pipeline 為核心,將 RAG、Agent、檢索、工具呼叫與生成拆成可組合、可測試的資料流。本文從官方 source code 出發,帶你理解它的設計、最小 RAG 實作與適合的落地場景。 2026年8月20日 閱讀更多
AI 工具指南 Pathway RAG 當資料不再只是批次:用 Pathway 建立可持續更新的即時 RAG 管線 RAG 系統最容易被低估的成本,不是第一次把文件塞進向量資料庫,而是之後如何持續接住變動中的資料。Pathway 把串流處理、即時分析與 LLM 管線放進同一個 Python 框架,讓我們可以用接近資料工程的方式建立會自動更新的 RAG 應用。 2026年8月18日 閱讀更多
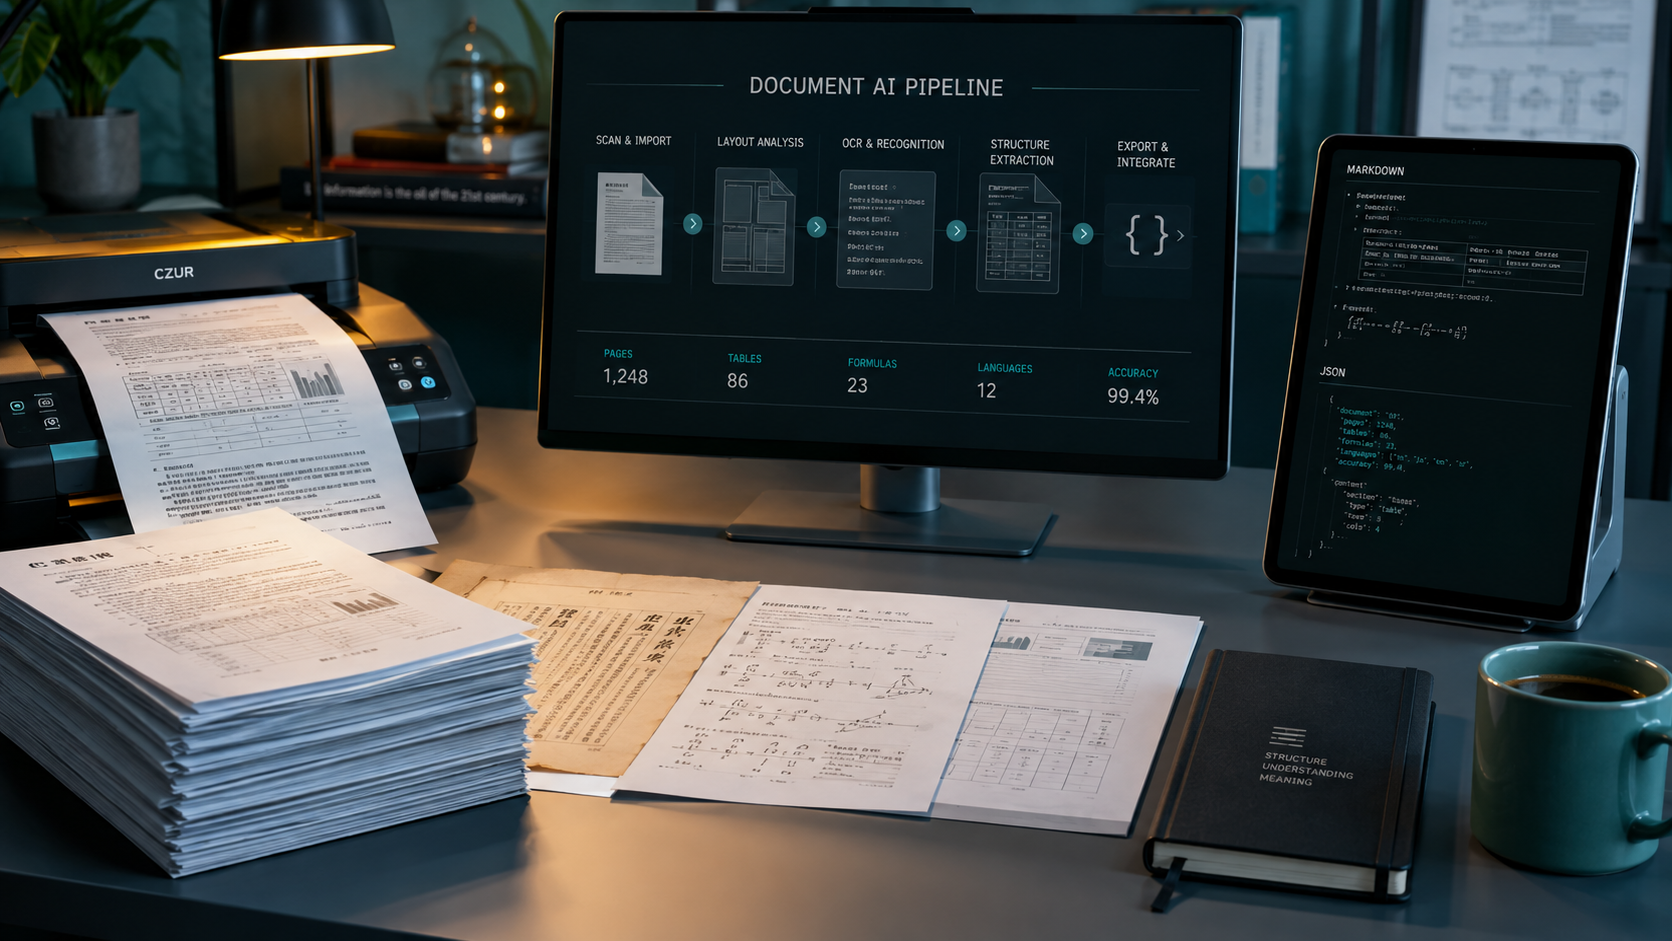
AI 工具指南 PaddleOCR RAG 別再把 OCR 當成純文字辨識:PaddleOCR 如何把 PDF 變成 LLM 能用的資料 PaddleOCR 的價值不只在把圖片轉成文字,而是把 PDF 與影像中的版面、表格、公式與多語內容整理成 Markdown 或 JSON,成為 RAG 與 Agent 可以真正消化的輸入。本文從 PP-OCR、PP-StructureV3 到 PaddleOCR-VL,拆解它的架構、上手方式與導入限制。 2026年8月16日 閱讀更多
AI Engineering RAG AI Agent AnythingLLM:把私有知識庫、RAG 與 AI Agent 收進一個可自架工作台 AnythingLLM 是一套以 local-first 為核心的開源 AI 工作台,將文件問答、RAG、AI Agent、多使用者權限與多種模型/向量資料庫整合在同一個可自架應用中。本文從架構、資料流程、部署選擇與隱私邊界,拆解它適合什麼團隊,以及導入時最容易忽略的工程細節。 2026年8月15日 閱讀更多
開源 工具 RAG MinerU:把 PDF 與 Office 文件轉成 LLM 可用的 Markdown/JSON 文件進入 RAG 或 Agent 工作流前,真正棘手的往往不是向量資料庫,而是如何保留版面、表格、公式與圖片語意。MinerU 將 PDF、圖片、DOCX、PPTX、XLSX 解析成 Markdown 與 JSON,並提供 CLI、API、WebUI 與多服務路由,適合作為文件 AI 管線的前處理層。 2026年8月14日 閱讀更多
開發者工具 AI 工具指南 開源 把本地模型變成可用的 AI 後端:PrivateGPT 1.0 的 API-first 實作路線 PrivateGPT 1.0 不是模型執行器,而是一層 API-first 的 private AI application backend:把本地 inference server 與 RAG、引用、工具、MCP、資料庫查詢及前端應用連接起來。本文拆解其架構、安裝路徑、導入順序與安全邊界。 2026年8月9日 閱讀更多
AI 工具指南 Dify RAG Dify:用視覺化方式打造企業級 AI Agent 工作流,從原型到生產只需一天 Dify 讓非技術人員也能透過拖曳元件建立完整的 AI Agent 工作流,從 RAG 檢索、多步驟決策到 API 串接一次搞定。這篇文章帶你了解 Dify 的核心架構、實際上手步驟,以及它如何改變企業導入 AI 的方式。 2026年7月14日 閱讀更多