Google LangExtract:把 LLM 抽取结果钉回原文,让非结构化文字真正可验证
Google LangExtract:把 LLM 抽取结果钉回原文,让非结构化文字真正可验证
很多 LLM 应用的第一个 demo 都是「把一段文字丢进模型,请它回传 JSON」。真正进入产品后,问题才开始浮现:这个栏位是从哪一句话抽出来的?模型是不是把 few-shot 范例误当成输入内容?长文件切段之后,跨段落的关系还在不在?如果使用者不能回到原文核对,结构化输出看起来再漂亮,也很难成为可靠的资料管线。
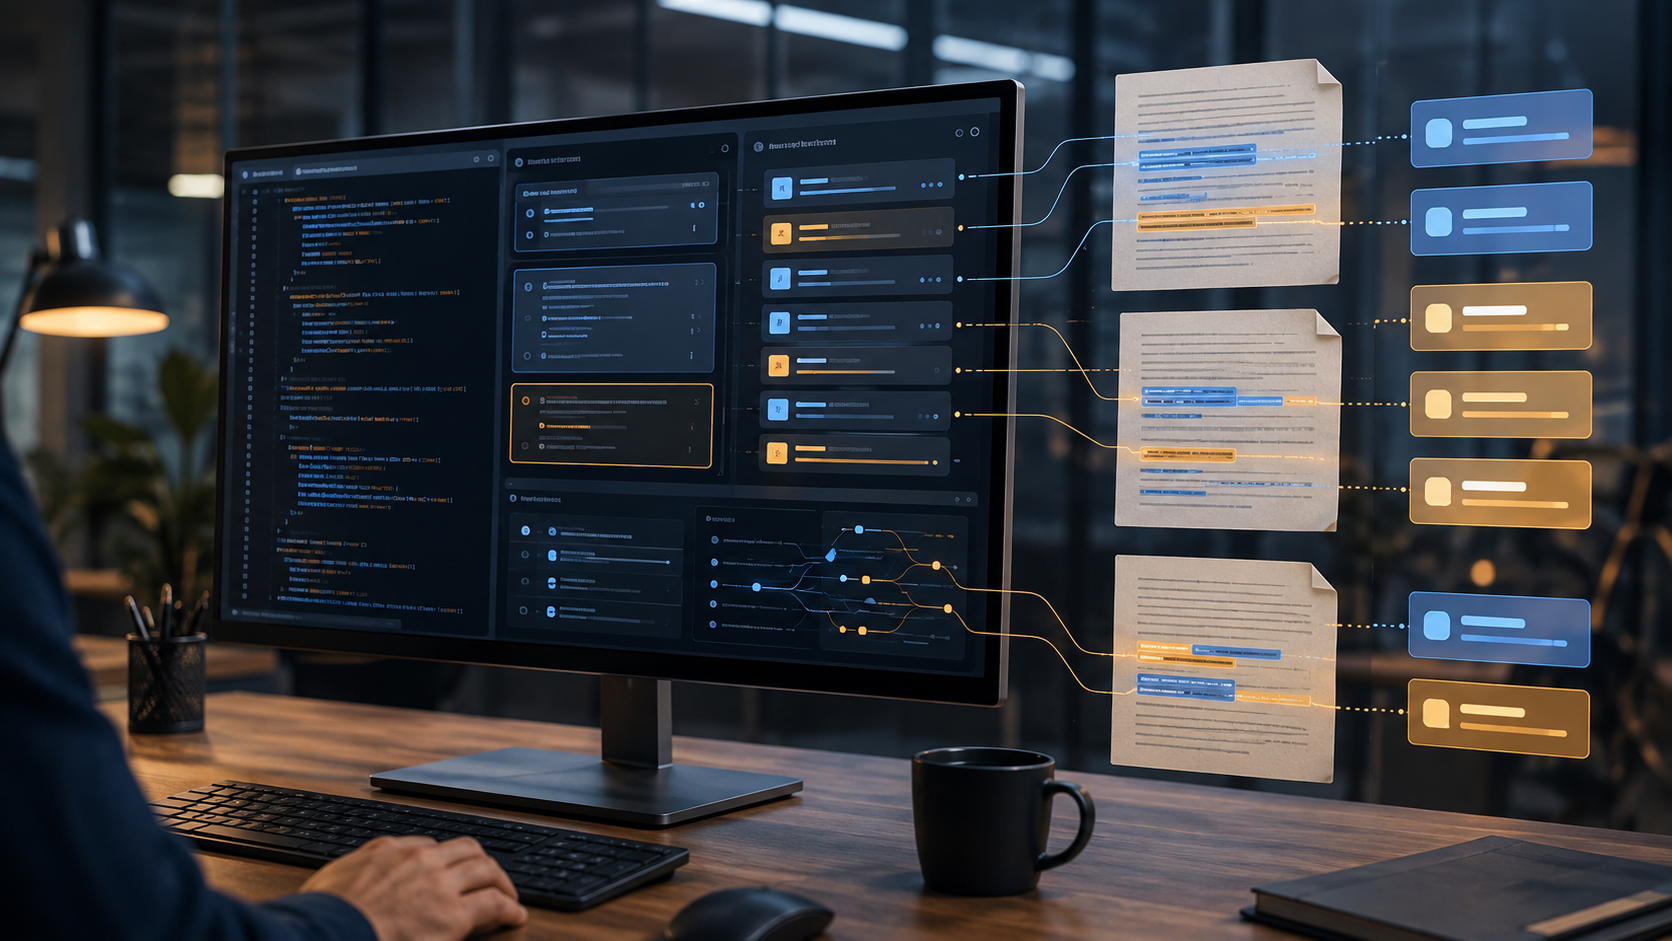
我这次在 GitHub 高星专案扫描中选到 Google 的 langextract。截至本次查核,它已经超过 3.8 万颗星,且最近仍有更新;专案采 Apache 2.0,定位是一个 Python library,不是单纯的 prompt 范例或资源清单。它的核心价值也很清楚:用 LLM 从非结构化文字抽取结构化资讯,同时把每个 extraction 对应回来源文字的精确 character span,再输出可互动检视的 HTML。
这个设计让 LangExtract 不只是「让模型吐 JSON」,而是把抽取结果、来源证据和人工审查放在同一条工作流里。我的判断是:如果你的 AI 应用需要处理长文件、医疗纪录、客服对话、法务文件或研究资料,真正值得研究的不是它能不能抽出栏位,而是它能不能让每个栏位都保留可追溯的证据。
先讲结论:LangExtract 解的是可追溯性,不是幻觉的终结
LangExtract 最有辨识度的设计有四个层次:
1. 用自然语言指令与 few-shot examples 定义抽取任务,不需要先微调模型。
1. 把长文件切成可处理的 chunks,再平行送出推论,必要时可用多个 extraction passes 增加召回率。
1. 把模型回传的 extraction 对齐回原文,每笔资料可带 char_interval、alignment_status、attributes 等资讯。
1. 把 JSONL 与互动式视觉化接起来,让人可以在原文脉络中检查结果,而不是只看一张扁平表格。
这四层组合起来,才是它和一般「LLM + JSON schema」范例的差异。Schema 可以限制输出的形状,却不等于输出有证据;LangExtract 把「资料长什么样」和「资料在来源哪里」一起处理。
但这里要先划清界线:source grounding 只能回答「这段文字能不能在输入中找到」,不能保证模型推导出的 attribute 一定是真的。README 也明确提醒,推论品质仍会受模型、prompt、范例和任务复杂度影响。对医疗、法律或金融场景来说,它是可审查性基础,不是自动核准器。
它的资料模型,为什么比一个 JSON dictionary 更实用?
在 LangExtract 的核心资料模型里,一笔 Extraction 至少包含 extraction_class 和 extraction_text,还可以带上 char_interval、alignment_status、extraction_index、group_index、description、attributes。其中最关键的是 char_interval:它使用来源文字的起讫位置表示 extraction 的范围,起点包含、终点不包含。
这个决定带来三个实务好处:
- 可以反查证据:前端不用猜测哪句话支持某个栏位,直接用字元区间标亮原文。
- 可以区分未对齐结果:如果模型从 few-shot example 借用了文字,而该文字不在真正输入里,系统可能无法定位,
char_interval会是None。这比悄悄把错误资料塞进资料库更安全。 - 可以保留关系与属性:例如抽取一个药物名称,再用 attributes 放 dosage、route 或 frequency;或者抽取人物与关系,让后续资料处理不必重新解析一段自然语言。
这也是我认为 LangExtract 适合做「人机协作资料整理」的原因。模型先提出候选,系统保留证据,人再依照原文快速验证。它不是把人工审查拿掉,而是把人工审查从「重新阅读整份文件」缩小成「确认已标出的片段」。
从 prompt 到视觉化:一条完整的抽取管线
1. 用 examples 定义输出行为
LangExtract 的 examples 不是装饰,它们同时示范抽取类别、原文片段和 attributes。官方文件特别要求 extraction_text 尽量逐字出现在 example 的 text 中,并且依照原文出现顺序排列;如果范例有 paraphrase、重叠或顺序错误,系统会出现 prompt alignment 警告。
这个要求看似严格,实际上很合理。若你希望后面能把结果对回原文,example 本身就不能先破坏「文字证据 ↔ 结构化栏位」的对应。换句话说,LangExtract 把资料标注习惯往 prompt 设计前移了。
2. 长文件先切块,再推论
官方范例提供 max_char_buffer、max_workers 和 extraction_passes 等参数。切块是为了控制每次送进模型的上下文大小;平行处理可以提高吞吐量;多次 extraction pass 则是用额外成本换取更高召回率。
原始码中的 Annotator 会把文件转成 chunks,将 chunk 组成 prompt,交给 language model,再交给 resolver 将模型输出解析与对齐回原文。多个 pass 的结果会合并;如果不同 pass 的 extraction 位置互相重叠,原始码采用「较早 pass 优先」的策略,后续 pass 只补进不重叠的结果。
这个行为值得记进产品设计文件:extraction_passes=3 不是免费的「再跑两次」,它可能提高召回率,也会增加模型请求、费用、延迟和去重判断的复杂度。对大量文件,应先用小样本比较单次与多次 pass 的 precision、recall 和成本,再决定预设值。
3. Provider factory 把模型选择和抽取逻辑分开
目前专案用 provider factory 和 entry points 发现模型供应商。内建 provider 包含 Gemini、Ollama 和 OpenAI,ModelConfig 可以用 model_id、明确的 provider 以及 provider_kwargs 建立模型。这让抽取程式不必把每个模型 API 的初始化方式硬编码在业务逻辑里。
对团队来说,这个分层比「支援很多模型」更重要。你可以先用本机 Ollama 做资料格式和对齐测试,再切到云端模型做品质或吞吐量评估;抽取任务的 examples、输出处理和视觉化流程不需要整套重写。
不过不同 provider 的能力并不完全相同。README 目前说明 Gemini 与 OpenAI 支援 output_schema 的情境,而 Ollama 尚不支援这个参数;使用 OpenAI-compatible endpoint 时,也可能需要明确指定 provider 和 base_url。因此不要把「同一个 model_id 呼叫方式」误解成「所有 provider 的输出保证相同」。
4. JSONL 不是终点,互动式 HTML 才是审查介面
抽取结果可以用 lx.io.save_annotated_documents 写成 JSONL,再交给 lx.visualize 产生 self-contained HTML。这个 HTML 的价值不在于展示漂亮,而在于把大量 extraction 放回原文脉络中。
对资料工程而言,JSONL 适合进入下游 pipeline;对分析师或领域专家而言,视觉化页面适合快速检查。两者并存,让同一份结果同时服务机器处理和人工 QA,而不是为了人工检查另做一套资料格式。
如何开始:先用本机 Ollama 做一个可验证任务
下面用官方支援的 Ollama provider 示范,避免把 API key 直接放在程式里。前置条件是 Python 3.10 以上、已安装 Ollama,并且有足够记忆体执行你选择的模型。
先建立隔离环境并安装套件:
python -m venv .venv
source .venv/bin/activate
pip install langextract
启动 Ollama 并准备一个模型:
ollama serve
ollama pull gemma2:2b
接着把任务缩小成「从一段客服纪录中抽取产品、问题与严重度」。重点不是让模型写一篇摘要,而是要求它引用输入中确实存在的文字:
import langextract as lx
prompt = """
Extract product names, reported problems, and severity in order of appearance.
Use exact text from the input. Do not paraphrase or overlap extractions.
Put a short normalized label in attributes when useful.
"""
examples = [
    lx.data.ExampleData(
        text="使用者回报 CloudBox 在同步相片时显示逾时,影响程度为高。",
        extractions=[
            lx.data.Extraction(
                extraction_class="product",
                extraction_text="CloudBox",
                attributes={"normalized": "CloudBox"},
            ),
            lx.data.Extraction(
                extraction_class="problem",
                extraction_text="同步相片时显示逾时",
                attributes={"normalized": "sync timeout"},
            ),
            lx.data.Extraction(
                extraction_class="severity",
                extraction_text="高",
                attributes={"normalized": "high"},
            ),
        ],
    )
]
text = "使用者说 CloudBox 登入正常,但同步相片仍逾时,这次影响程度为中。"
result = lx.extract(
    text_or_documents=text,
    prompt_description=prompt,
    examples=examples,
    model_id="gemma2:2b",
    model_url="http://localhost:11434",
)
# 只保留能定位回输入文字的结果
for extraction in result.extractions:
    if extraction.char_interval:
        print(
            extraction.extraction_class,
            extraction.extraction_text,
            extraction.char_interval,
            extraction.attributes,
        )
这段程式的第一个验证点不是「模型有没有回传三个栏位」,而是每个结果是否有 char_interval,以及 extraction_text 能否在输入中被核对。若 Ollama 模型没有产生稳定结果,先检查服务是否真的在 localhost:11434、模型名称是否已 pull,以及 examples 是否遵守逐字、非重叠、依序出现三个条件。
完成小文件测试后,再加入 JSONL 与 HTML:
lx.io.save_annotated_documents(
    [result], output_name="extraction_results.jsonl", output_dir="."
)
html = lx.visualize("extraction_results.jsonl")
with open("visualization.html", "w", encoding="utf-8") as file:
    file.write(html.data if hasattr(html, "data") else html)
对长文件,可以把 text_or_documents 改成官方支援的 URL 或文件集合,再逐步调整:
result = lx.extract(
    text_or_documents="https://www.gutenberg.org/files/1513/1513-0.txt",
    prompt_description=prompt,
    examples=examples,
    model_id="gemma2:2b",
    model_url="http://localhost:11434",
    extraction_passes=2,
    max_workers=4,
    max_char_buffer=1000,
)
我会建议先保守设定 max_workers,因为本机模型的吞吐量通常比 API 文件中的理论并行度更容易成为瓶颈;先量测记忆体、延迟和结果品质,再增加平行度。
三个最容易踩到的坑
坑一:把 grounding 当成 fact checking
char_interval 能证明抽取文字落在输入中,不能证明输入本身正确,也不能证明 attributes 的推论没有偏差。例如模型可以把「高风险」这个词从原文标出来,但「高风险」是否符合公司的风险定义,仍需要规则、资料库或专家审核。
比较稳妥的资料表设计,是把 source_text、char_start、char_end、extraction_class、attributes 和 review_status 分开保存。不要只保存模型最后整理出的栏位,否则后续仍然要重新呼叫模型才能追查。
坑二:examples 写得像摘要,结果就会失去可对齐性
如果 example 的 extraction_text 不是原文片段,或同一段文字有重叠的 extraction,模型可能学到不一致的标注习惯。README 提到的 prompt alignment 警告不是可以忽略的噪音,而是资料契约出了问题的讯号。
我的做法是先用一个很短的 example 跑通,再增加第二个 example 覆盖边界情况:同义词、同一实体多次出现、相邻实体、没有任何符合项目的文件。每次只改一个变因,才知道品质变化来自 prompt、模型还是 resolver。
坑三:长文件的成本不只取决于字数
切块、平行、多次 pass、context window 都会影响实际成本。extraction_passes 增加时,模型请求数和结果合并风险也可能增加;max_char_buffer 太小,跨句关系可能被切断;max_char_buffer 太大,又可能使模型在一个 chunk 内漏掉细节。
正式导入前至少建立一个小型 benchmark:固定一批人工标注文件,记录每个设定的 precision、recall、未对齐比例、平均延迟、token 或 API 成本。没有这些数据时,不要只因为多 pass 看起来更「仔细」就把它设成预设值。
LangExtract 适合放在什么位置?
它不是向量资料库,也不是完整的 RAG framework,更不是取代 OCR、资料库验证或 workflow orchestration 的平台。它比较像一个「以 LLM 为核心、但把证据对齐与人工审查纳入设计」的抽取层。
- 和传统 NER 比:LangExtract 更容易用 few-shot examples 调整任务,也能抽 attributes 与关系;代价是需要模型推论,稳定性、成本和延迟要管理。
- 和直接要求 JSON 比:它多了来源区间、对齐状态和视觉化;但 schema 或 provider 能力仍有差异,不能假设每个模型都提供同等强度的 constrained output。
- 和 RAG 比:RAG 的重点是找回相关内容供生成使用;LangExtract 的重点是把内容转成可追溯的结构化标注。两者可以串接,例如先从合约抽取条款,再把带证据的结果建立索引。
- 和资料标注工具比:LangExtract 可以先做机器预标注与证据标记,让人工审核更快;但高风险资料仍要保留人工覆核流程。
谁适合先试?
我会优先推荐给三类团队:第一,手上有大量文字,但人工整理成本高;第二,不能接受只拿到没有来源的 JSON;第三,希望在云端模型与本机模型之间保留切换空间。客服工单、研究摘要、合约条款、医疗纪录结构化、产品回馈分类,都是合理的试点。
不适合直接导入的情况也很明确:如果你的任务只需要非常稳定的固定格式转换,传统 parser 或规则可能更便宜;如果你要求每个推论 attribute 都具备外部世界的真值保证,单靠 LangExtract 不够;如果文件包含敏感资料,又没有完成资料传输、模型供应商和保存政策审查,不应只因为 API 很方便就上线。
另外,专案 README 明确提醒 LangExtract 并不是 Google 官方支援的产品;若用于健康相关应用,还要遵守其列出的相关使用条款。这些不是页尾免责声明而已,而是评估导入范围时必须列入的治理条件。
我的判断
LLM 抽取的下一个竞争点,不会只是「谁能输出更漂亮的 JSON」,而是「谁能让团队更快相信、检查并修正这份 JSON」。LangExtract 把 source grounding、chunking、provider abstraction 和 visualization 放在同一个 Python library 里,让开发者可以从一个小任务开始,逐步测量抽取品质,再决定要不要扩张到长文件与批次处理。
它不会消除模型错误,也不会替你完成领域验证;但它把最常被忽略的证据链补上了。对 AI Chain 读者来说,我认为最值得带走的不是某一个 model_id,而是这个设计原则:任何会进入资料库、决策流程或人工审查的 LLM 输出,都应该尽量保留它在来源中的位置,以及人下一步要如何验证它。
参考资料
- LangExtract GitHub repository
- LangExtract 官方 README:Quick Start、长文件与 provider 使用方式
- LangExtract
factory.py:ModelConfig 与 provider discovery - LangExtract
core/data.py:Extraction 与 CharInterval 资料模型 - LangExtract
annotation.py:切块、multiple passes 与 extraction 合并 - LangExtract provider system 文件
- LangExtract Apache 2.0 License