LlamaIndex 不只是 RAG:把私有资料接上 Agent 的实作框架
LlamaIndex 不只是 RAG:把私有资料接上 Agent 的实作框架
我观察到很多团队在导入 LLM 时,第一个原型往往很快:把使用者问题放进 prompt,再把模型回复显示出来。但只要问题涉及公司文件、产品规格、客服纪录或资料库,真正的工程工作才开始出现。资料要从哪里读进来?PDF 的版面如何保留?文件要怎么切分?检索结果如何排序?Agent 什么时候该查资料,什么时候该呼叫工具?
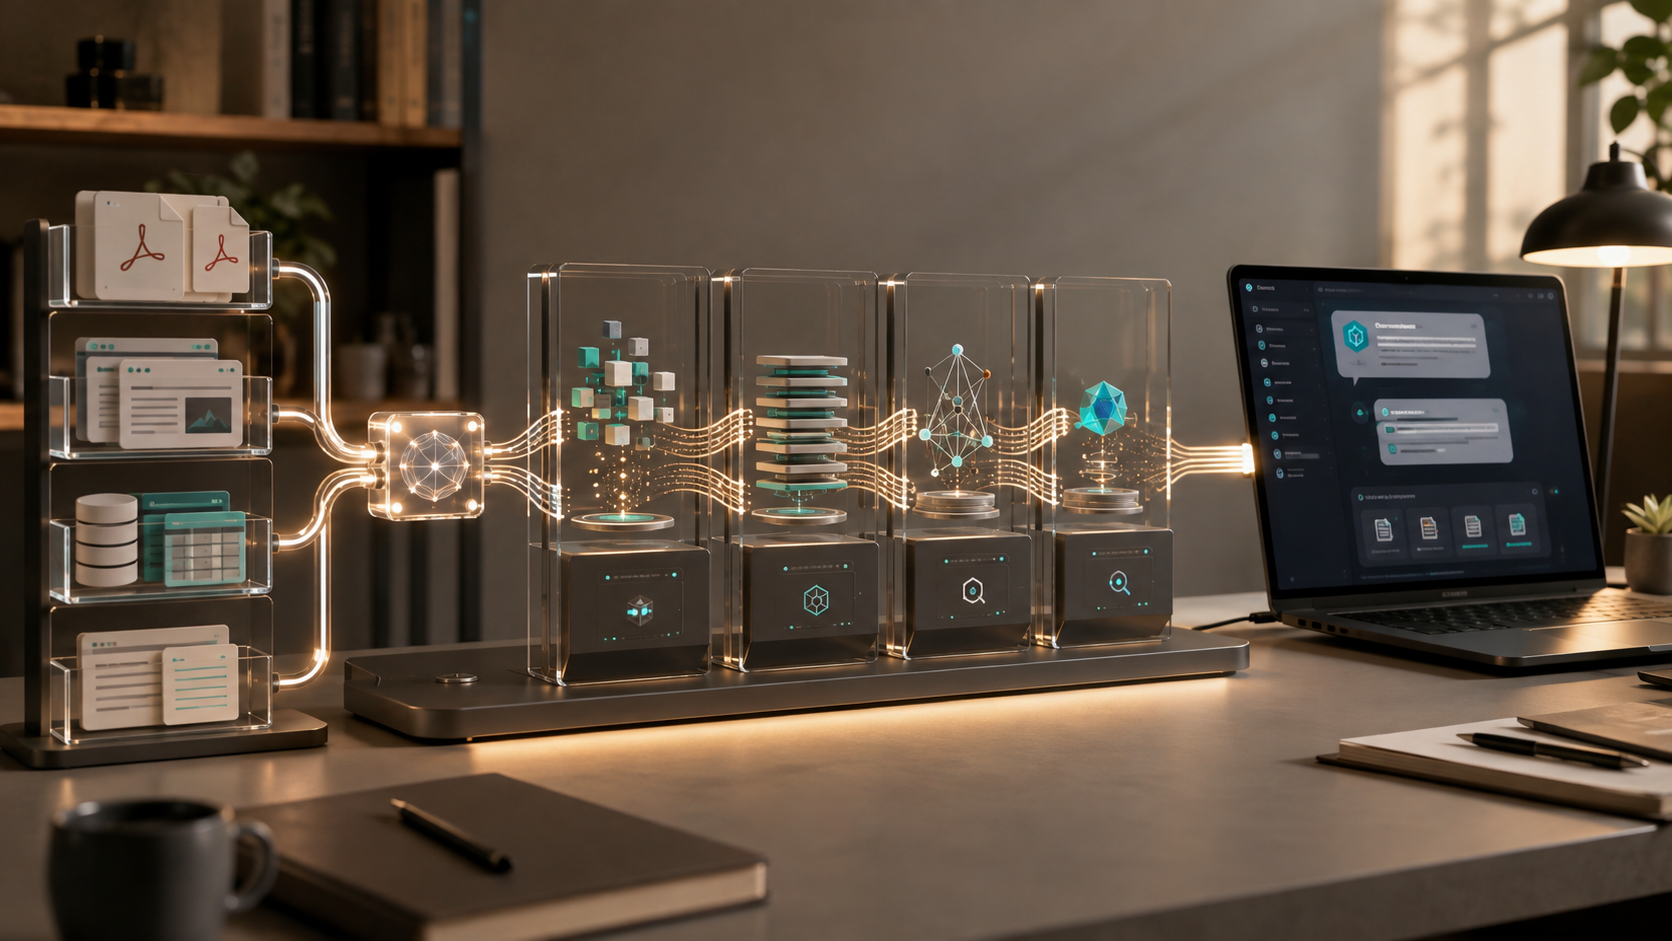
这也是我认为 LlamaIndex 值得被重新理解的原因。它不只是「做 RAG 的套件」,而是一个把外部资料接到 LLM 与 Agent 之间的资料框架。官方目前将 LlamaIndex OSS 定位为建立 agentic applications 的开源 framework;README 同时保留了它最核心的资料框架精神:连接资料、建立结构、检索相关上下文,再交给应用程式或模型使用。
先讲结论:LlamaIndex 解决的是资料上下文工程
如果你的问题只是「怎么呼叫一次模型」,LlamaIndex 可能显得太重。但如果你的应用需要持续处理私有资料,并且希望把资料来源、索引、Retriever、Query Engine 与 Agent 工作流程拆成可以测试与替换的元件,它就很有价值。
我会把它的价值浓缩成三层:
1. 资料接入层:把 PDF、文件、网页、API、SQL 等来源转成应用程式可以处理的 Document 或 Node。
1. 上下文组织层:透过切分、metadata、index、embedding、retriever 与 reranker,决定模型看到哪些资料。
1. 推理与工作流程层:将检索结果交给 query engine、chat engine、Agent 或 Workflow,形成可互动的应用。
这个分层很重要,因为 RAG 的失败通常不只来自模型。资料没有正确载入、切分边界错误、metadata 遗失、检索召回不准,最后都会被误认为是「LLM 不够聪明」。LlamaIndex 的好处,是让这些环节有比较清楚的程式设计边界。
从官方架构看懂它为什么能扩充
LlamaIndex 的 Python 套件采取 core 加 integrations 的命名方式。llama-index-core 提供核心抽象;另外再依照应用选择 LLM、embedding、向量储存、资料载入器或其他整合套件。官方 README 提到,LlamaIndex 有超过 300 个 integration packages,这种设计的重点不是让你一次安装全部,而是把供应商与核心流程解耦。
例如,核心程式可以使用通用的 LLM 与 Retriever 介面,底层再替换成不同模型供应商或向量资料库。这让团队在早期原型阶段可以快速开始,到了正式环境也能针对成本、延迟、资料隔离或部署方式替换元件。
不过,抽象层不是免费的。当你遇到检索品质问题时,必须知道目前使用的是哪个 integration、哪一个 embedding、哪种 index,以及资料在何处被切分与持久化。只会呼叫高阶 API,却不理解底层资料流,仍然很难除错。
实作一:先做一个可验证的文件问答
我建议不要一开始就做多 Agent。先建立一个最小但可验证的文件问答流程,确认资料真的能被找回来。以下范例示范使用本地目录建立索引,再对资料提出问题:
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
documents = SimpleDirectoryReader("./data").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()
response = query_engine.query("这份文件的核心结论是什么?")
print(response)
这段程式很短,但不代表正式系统只需要这几行。第一次验证时,我会特别检查三件事:
./data里的文件是否真的被载入,而不是读取失败后得到空索引。- 问题的答案是否能在来源文件中找到,并且没有把模型自身的常识误认为检索结果。
- 文件更新后,索引是否需要重建、增量更新或清除旧版本。
若要在本地建立干净环境,可以先用 uv init 建立专案,再执行 uv add llama-index。接着把一两份可公开测试的文件放进 data,执行程式,确认至少能完成「载入、建立索引、查询、输出」这四个步骤。这个验证点比先接十个资料源更重要,因为它能把环境问题与检索问题分开。
实作二:把资料来源与模型供应商拆开
真正进入团队专案后,我不会把所有设定直接写死在单一 Python 档案。至少应该把资料载入、模型设定、索引建立与查询介面分开。概念上可以整理成以下结构:
app/
  settings.py       # 模型、embedding、环境设定
  ingest.py         # 资料载入与切分
  index.py          # 索引建立与持久化
  query.py          # query engine 或 agent
  evaluation.py     # 测试问题与检索评估
data/
这样做的原因很实际。当模型供应商变更时,不应该重新改写资料载入流程;当向量资料库从本地储存换成远端服务时,也不应该影响前端的问答介面。LlamaIndex 的 core 与 integration 分离,正好可以支援这种边界。
另一个要点是持久化。原型可以每次启动都重建 index,但正式服务通常需要保存索引,并且记录资料版本、embedding 模型版本、切分参数与建立时间。否则当答案改变时,你很难判断是原始文件更新、索引更新,还是模型设定改变。
实作三:再把检索能力交给 Agent
当文件问答稳定后,才适合把它包成 Agent 的工具。Agent 的价值不是把「查资料」包装成一个更酷的名称,而是让系统能根据任务选择工具、执行多步骤工作,并在需要时回到资料索引。
这里要先分清楚三个层次:
- Retriever 负责找出可能相关的资料。
- Query Engine 或 Chat Engine 负责把查询与上下文组合成回复。
- Agent 负责决定下一步要做什么,例如查询文件、呼叫 API 或执行另一个工具。
如果把三者混成一个黑盒,问题发生时就很难定位。我的做法是先为 Retriever 写固定问题集,确认召回内容;再测试 Query Engine 的回答是否忠于上下文;最后才测试 Agent 的工具选择与多步骤行为。
LlamaIndex 的 Workflow 也值得注意。对于需要多步骤、事件驱动或可重跑的 Agent 流程,Workflow 比把所有逻辑塞在一个巨大 prompt 里更容易观察与测试。你可以把「取得问题、查询资料、整理上下文、产生答案、检查结果」拆成不同步骤,让每一步都有明确输入与输出。这种做法会增加一些程式码,但换来的是更好的可维护性。
文件处理是成败关键,不是附属功能
很多 RAG 示范使用纯文字档,所以看起来检索很简单。企业资料却可能包含表格、页首页尾、扫描影像、栏位、附件与版本标记。资料解析若在最前面就遗失结构,后面的 embedding 与生成再精准也救不回来。
LlamaIndex 生态除了 OSS framework,也在官方 README 中列出 LlamaParse 与相关文件代理能力。这些服务可以处理更复杂的文件解析、结构化撷取与索引流程,但它们是另外的云端平台,不应该和开源核心混为一谈。导入前要先确认资料是否能离开内网、API key 如何管理、费用如何估算,以及是否需要保留自建解析方案。
我的建议是先建立资料品质检查表:文件是否完整、编码是否正确、表格是否可读、页码与来源 metadata 是否保留、同一文件的不同版本是否能辨识。这些检查比调整 prompt 更接近 RAG 的根因。
LlamaIndex 的限制:它不会自动保证答案正确
第一个限制是检索品质。框架可以提供组件,但无法替你决定最佳 chunk size、top k、metadata schema、embedding 模型或 reranking 策略。这些都需要用真实问题集评估。
第二个限制是成本与延迟。资料解析、embedding、向量搜寻、reranking 与 LLM 生成,每一层都可能产生费用或延迟。多步骤 Agent 会再增加工具呼叫次数。若只用「回答看起来合理」作为验收标准,很容易忽略高峰流量与长文件造成的成本。
第三个限制是抽象层带来的除错负担。当套件与 integration 很多时,版本相容性、API 变更、底层服务错误都需要被观察。正式环境应该固定依赖版本,记录检索来源与延迟,并提供能重现问题的 trace。
第四个限制是安全。只要 Agent 能读取私有资料或呼叫工具,就必须处理权限、资料范围、提示注入、敏感资讯外泄与工具滥用。不能因为框架提供了 Agent 介面,就把所有文件与操作权限一次交给模型。
我会怎么评估一个 LlamaIndex 专案
在我看来,评估重点不是「能不能在五行程式码中跑起来」,而是以下五个问题:
1. 资料能否被正确表示? 来源、版本、权限与 metadata 是否完整。
1. 检索能否被量化? 是否有一组真实问题,能测试召回率、排序与引用正确性。
1. 元件能否替换? LLM、embedding、向量储存与解析器是否被清楚隔离。
1. 流程能否观察? 能否知道 Agent 为什么选工具、取了哪些上下文、花了多少时间与成本。
1. 失败是否可控? 找不到资料、模型超时、外部 API 失败或权限不足时,系统是否会安全降级。
这五题若答不出来,就算 demo 很漂亮,我也不会直接把它推进正式环境。
哪些团队适合先试?
我会推荐以下团队优先评估:已经有文件问答或知识库需求、希望用 Python 建立 LLM 应用、需要连接多种资料来源,或预期未来会从单纯 RAG 扩展到工具使用与 Agent workflow 的团队。
相反地,如果需求只是一次性文字摘要、固定模板生成,或团队没有能力维护资料管线与评估集,直接引入完整框架可能会增加复杂度。这时候一个轻量的 API 呼叫加上明确的资料处理程式,反而更容易维护。
结语:先把资料流做好,再谈 Agent
我对 LlamaIndex 的看法是:它真正的价值不在于替你包装一个聊天视窗,而在于提供一组可组合的资料与推理元件,让私有资料能比较有秩序地进入 LLM 应用。
最务实的导入顺序是:先用少量文件验证载入与检索,再把模型、embedding、index 与储存边界拆清楚,接着建立评估问题集,最后才加入 Agent 与 Workflow。这个顺序可能没有「一天做出全自动 Agent」那么吸睛,但比较能留下可维护、可观察、可治理的系统。
如果你正在做企业知识库、文件 Agent 或需要私有资料上下文的 AI 应用,LlamaIndex 值得放进候选清单。不过请把它当成资料上下文工程的基础设施,而不是正确答案的保证器。
参考资料