Netdata:把每秒级观测、边缘 ML 与 MCP 组成可诊断的 AI 可观测平台
# Netdata:把每秒级观测、边缘 ML 与 MCP 组成可诊断的 AI 可观测平台
监控工具很多,真正难的是在事故发生的那一刻,快速回答三个问题:哪里出问题、影响范围多大、下一步该做什么。只把 metrics 集中到一个仪表板,通常只能回答第一题的一部分。
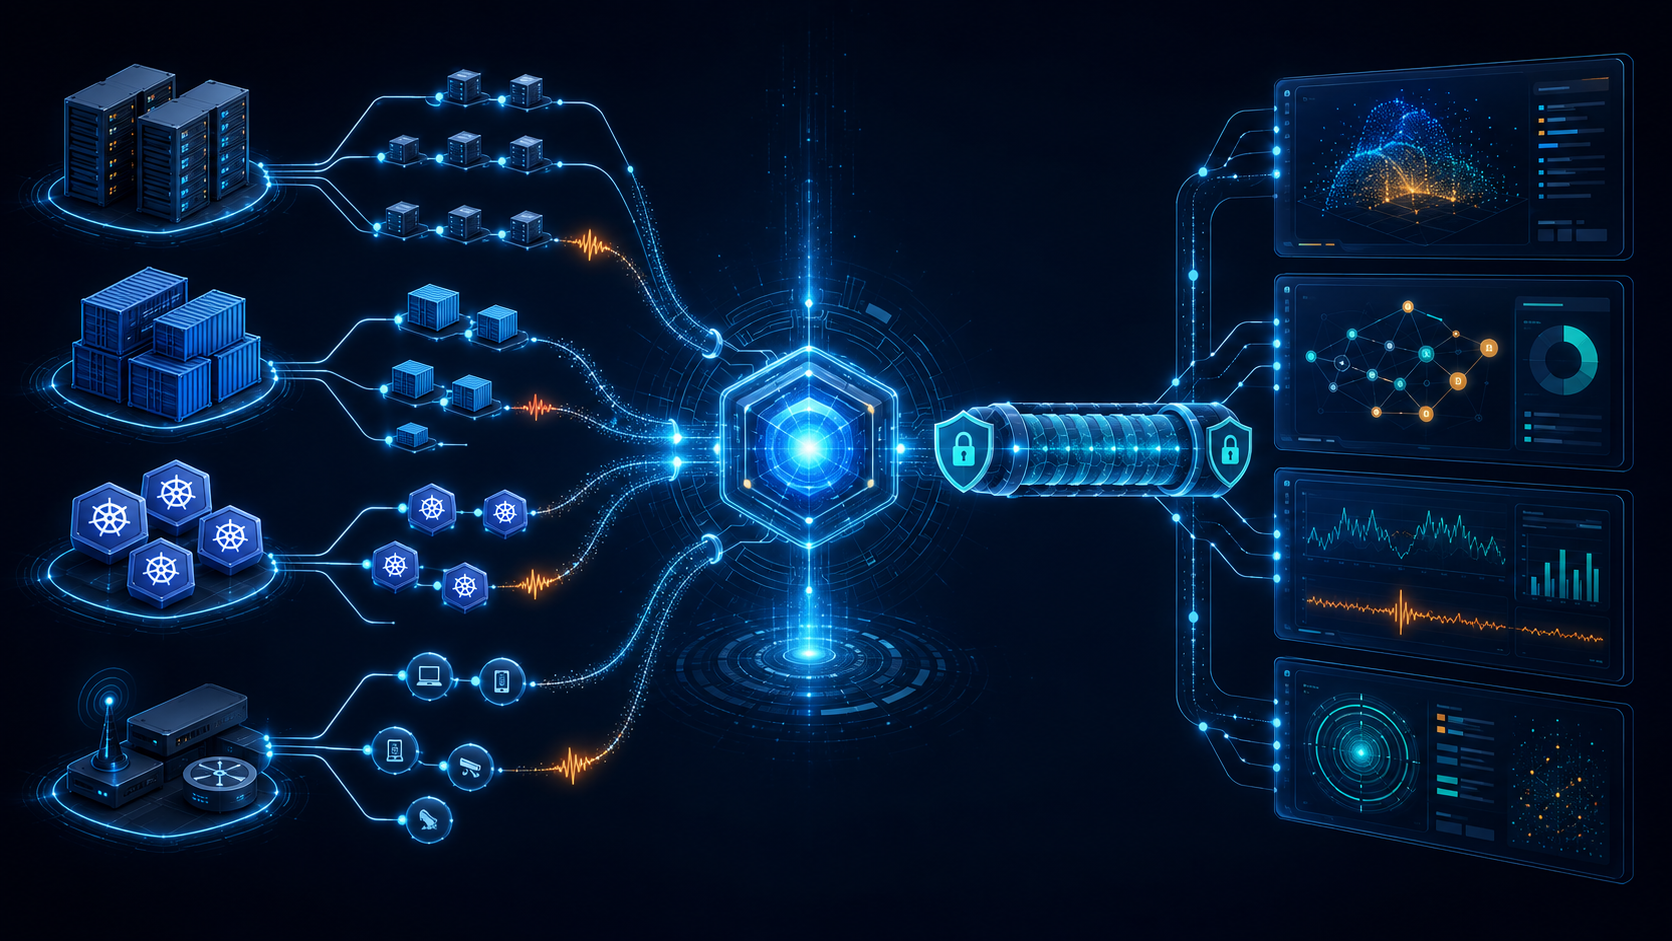
Netdata 的路线很不一样。它把 Agent 放在资料发生的边缘,持续收集每秒级讯号,在本地完成储存、异常侦测与告警,再透过 Parent-Child 架构把多台机器串成可扩展的观测管线。到了 v2.11.0,官方又把网路流量、拓扑、依赖关系与 MCP troubleshooting 放进同一个故事里。
这篇文章不把 Netdata 当成「安装后看图表」的工具,而是从工程角度拆解它如何把高解析度 telemetry 变成可诊断的 AI 工作流。
## 先给结论:Netdata 的核心不是图表,而是资料流
Netdata 官方将 Agent 描述为开源、即时的 infrastructure monitoring platform。它的核心优势有四个:
- **高解析度**:以每秒级频率收集与呈现指标,缩短事故时间轴上的盲区。
- **边缘处理**:收集、储存、ML 与告警可以在 Agent 所在的环境完成,不必先把所有原始资料送到集中式服务。
- **自动发现**:内建大量 integrations,能从系统资源、容器、VM、硬体、应用程式到 logs 建立可用的初始视图。
- **分散式扩展**:单机可以直接使用,多台 Agent 则可透过 Parent-Child 关系集中仪表板、保留资料与管理告警。
所以,Netdata 适合的不是「只想找一张漂亮 dashboard」的团队,而是需要在资料保留、事故分析与部署成本之间取得平衡的工程环境。
## Agent 在边缘做了什么?
把 Netdata 想成一个靠近被监控系统的资料平面,会比把它想成 dashboard 更准确。官方 README 将 Agent 的处理流程拆成 Collect、Store、Learn、Detect、Check、Stream、Archive、Query 与 Score:
1. **Collect**:收集系统、容器、应用程式、logs、API 与 synthetic checks。
2. **Store**:以 tiered time-series database 保留不同解析度的资料。
3. **Learn**:根据近期行为为每个 metric 建立 ML 模型。
4. **Detect**:用模型辨识异常,不必为每一条曲线手动写阈值。
5. **Check**:再以预设或自订 alert rules 做明确判断。
6. **Stream**:即时把资料送到 Parent,形成多层的集中与复写。
7. **Archive**:需要时汇出到 Prometheus、InfluxDB、OpenTSDB 或 Graphite 等系统。
8. **Query/Score**:透过 API 查询,并用 scoring engine 找出跨指标的模式与关联。
这个设计的价值在于:AI 分析不必等到资料跨网路、落进另一个平台、再被某个 batch job 处理。许多讯号可以在靠近来源的地方先被整理与判读,集中层则保留跨节点的视角。
### 每秒级资料不是越多越好,而是让时间轴可用
事故排查常常差在几十秒:一个短暂的 CPU spike、一段 connection pool 枯竭、一次容器重启前后的 latency 变化,都可能在低解析度聚合后消失。Netdata 的 tiered retention 让不同 zoom level 对应不同解析度:近期资料保留每秒级,较长时间则可以用每分钟或每小时的粒度查询。
这也带来一个务实的取舍:你不必让所有资料永久维持最高解析度,但可以在最需要的时间窗保留足够细节。
## 从异常侦测到 MCP:AI 介入的是「为什么」
传统 alert 告诉你「某个数值超过门槛」,但不一定能回答「为什么现在超过」。Netdata 的 edge-based ML 会根据历史行为做 unsupervised anomaly detection;v2.11.0 的 release notes 则进一步介绍 Netdata Cloud 的 AI Troubleshooting 与 MCP client capabilities。
官方文件对 MCP 的定位值得注意:Netdata Cloud 可以作为 MCP client,连到 GitHub、PagerDuty、Atlassian Cloud 或自订 MCP server,在调查告警时读取外部脉络。这和把 Claude 或 Cursor 连到 Netdata 自己的 MCP server 是反方向的整合。
换句话说,MCP 并不是把一个聊天视窗贴到 dashboard 上,而是把「告警的时间线」与「变更、工单、事件」放进同一个 investigation context。理想的流程会变成:
- Agent 侦测到某个 metric 偏离平常行为。
- Alert 与关联指标提供发生时间、节点与影响范围。
- Troubleshooting 层查询变更纪录、PagerDuty incident 或其他工具。
- 工程师得到的是带上下文的假设,而不是一张需要自行拼凑的曲线。
这里仍要保留工程判断:异常分数不是根因,AI 建议也不是变更授权。Netdata 的价值是缩短从「看到异常」到「形成可验证假设」的距离。
## v2.11.0:可观测性开始跨出主机边界
截至本文查证时,Netdata 最新 release 是 v2.11.0,发布于 2026 年 8 月 12 日。这个版本最值得注意的,不是单一 widget,而是它把 infrastructure context 往网路与依赖关系延伸。
### Network Monitor、flow 与 topology
官方 release notes 将 Network Monitor、Network Flows、Network Topology 与 Application Dependency Mapping 标为 Technical Preview。这代表功能已能使用,但介面、覆盖范围与支援方式仍会持续演进,不应把 preview 当成完全稳定的产品契约。
目前的方向包括:
- Network Flows 接收 NetFlow v5/v9、IPFIX 与 sFlow,将流量转成可搜寻、可分面分析的视图。
- SNMP topology engine 建立 Layer 2 与 Layer 3 网路地图。
- Linux 主机上的 Network Viewer 观察 process、container 与 Kubernetes workload 的通讯关系。
- Query Engine 改善 top-N 查询、latest time grouping、cardinality limit 与 tier query 的正确性。
这些能力串在一起后,排查路径不再只是「哪台主机的 CPU 异常」,而可以往下追到「哪个 workload 对哪个服务的网路互动改变」。对微服务、Kubernetes 与混合网路环境而言,这个上下文往往比单一主机指标更接近根因。
### 安全性不能被 AI 故事盖过
同一个 release 也列出 MCP ACL 与 bearer-token enforcement、匿名 MCP metadata 限制、WebSocket decompression-bomb guard、`ndsudo` privilege-escalation check,以及对安装参数与设定写入的加固。
这提醒导入者:只要 observability 平台开始读取 GitHub、PagerDuty 或内部工具,就必须把它当成高权限资料整合层。MCP connection 的 token scope、网路边界、audit log 与最小权限,不应等到事故发生后才补。
## 五分钟试跑:先在单一节点看见资料
最小实验可以先用 Docker 启动一个 Agent,确认本机资料收集与 dashboard 行为,再决定是否导入 Parent 或 Cloud:
```bash
docker run -d --name=netdata \
--pid=host \
--network=host \
-v netdataconfig:/etc/netdata \
-v netdatalib:/var/lib/netdata \
-v netdatacache:/var/cache/netdata \
-v /etc/passwd:/host/etc/passwd:ro \
-v /etc/group:/host/etc/group:ro \
-v /proc:/host/proc:ro \
-v /sys:/host/sys:ro \
-v /etc/os-release:/host/etc/os-release:ro \
--restart unless-stopped \
netdata/netdata
curl http://127.0.0.1:19999/api/v3/info
```
这个指令的目的不是直接宣称 production-ready,而是验证三件事:Agent 能否启动、主机指标是否出现、现有网路与权限政策是否允许监控所需的存取。正式环境仍应依官方安装文件、container security policy 与部署平台调整 volume、capability 及网路设定。
若要把资料送到集中层,再研究 Parent-Child streaming;若要接既有 metrics stack,则评估 Prometheus、InfluxDB 或 Graphite export。不要一开始就把所有功能全开,否则很难判断到底是资料模型、告警规则还是整合权限造成问题。
## 导入时最容易踩到的三个坑
### 1. 把 preview 功能当稳定 API
v2.11.0 的网路监控、flow、topology 与 dependency mapping 都明确标示为 Technical Preview。可以拿来做 proof of concept,但要为介面变更、覆盖率差异与未来 packaging 变化留下缓冲。
### 2. 只看异常分数,不建立可验证的 runbook
ML 可以降低手动设阈值的负担,却不能代替服务 owner 的判断。每一类重要告警都应该连到明确的检查步骤:看哪个 dashboard、比对哪个 deployment、确认哪一条依赖、何时需要 rollback。
### 3. 忽略资料保留与权限边界
每秒级资料、logs、长期 retention 与跨节点 streaming 都有成本。先定义哪些资料留在 edge、哪些资料送到 Parent、哪些资料可以汇出,以及谁能读取或触发外部 MCP connection,再决定架构。
## Netdata 适合谁?
如果你的团队符合以下条件,Netdata 值得列入评估:
- 需要比传统 1 分钟聚合更细的事故时间轴。
- 想先在节点本地完成观测与异常分析,再选择性集中。
- 同时管理 VM、容器、Kubernetes、网路设备与多种应用程式。
- 希望从「告警」逐步走向「带上下文的 troubleshooting」,但不想先重建整套 telemetry pipeline。
相反地,如果你只需要一个既有云端监控服务的极简 agent,或组织已经把所有查询、告警与治理标准锁定在另一套平台,Netdata 的完整能力可能反而增加营运选项。
## 结语:可观测性的下一步是缩短推理链
Netdata 的工程价值,不在于它列出了多少图表,而在于它把 Collect、Store、Learn、Detect、Check、Stream 与 Query 组成一条靠近资料来源的 pipeline,再把网路拓扑与 MCP context 接回 troubleshooting。
对 AI 应用而言,真正有用的 observability 不是「让模型看到更多资料」,而是让资料带着时间解析度、节点关系、依赖脉络与权限边界进入推理流程。Netdata 目前的路线,正是在这个方向上把 monitoring platform 推进成可诊断的 infrastructure system。
## 查证资料
- GitHub repository:
- GitHub repository metadata(星数、最后更新时间、授权):
- README:
- v2.11.0 release notes:
- Distributed observability pipeline:
- Netdata AI 与 troubleshooting 文件:
- 查证时间:2026-08-31 UTC;GitHub API 回报 80,379 stars、最后推送 2026-08-31,符合星数大于 5,000 且 180 天内更新的条件。