别再把 OCR 当成纯文字辨识:PaddleOCR 如何把 PDF 变成 LLM 能用的资料
别再把 OCR 当成纯文字辨识:PaddleOCR 如何把 PDF 变成 LLM 能用的资料
如果你曾经把扫描 PDF 接进 RAG,应该很快就会遇到一个尴尬问题:文字明明被抽出来了,回答品质却没有因此变好。表格栏位被打散、标题层级消失、双栏文件阅读顺序错乱,公式和图片也只剩下一串难以使用的字元。对 LLM 来说,这不是「有没有 OCR」的问题,而是输入资料是否保留了文件原本的结构。
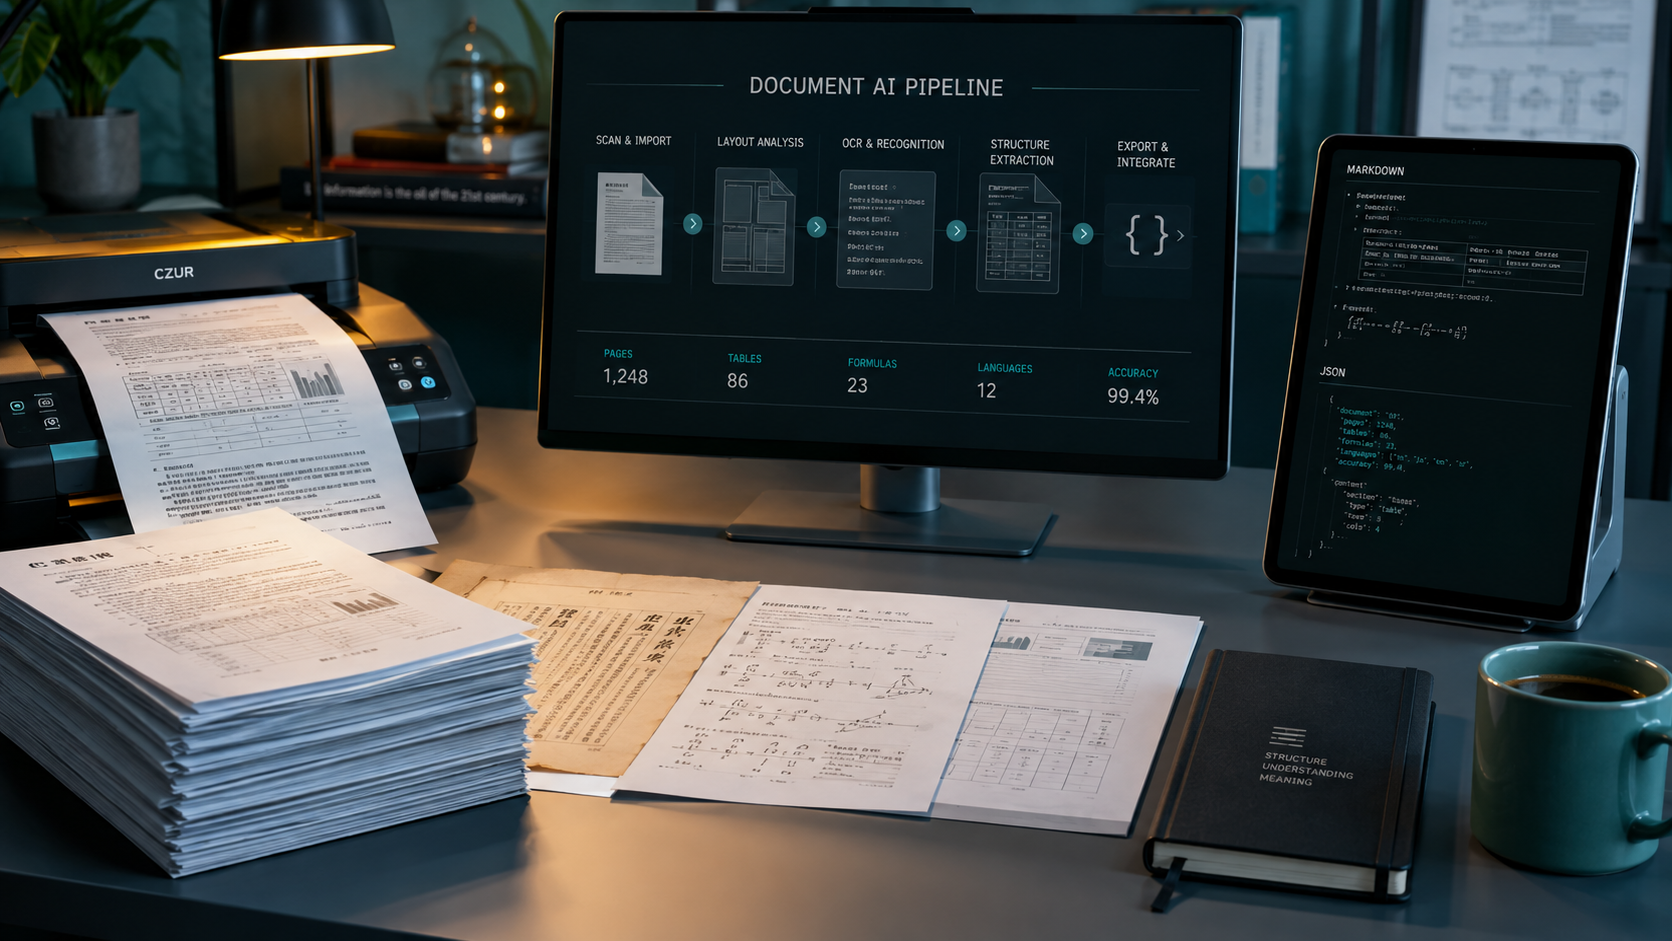
我认为 PaddleOCR 最值得注意的地方,正是它没有把 OCR 停在文字辨识终点。PaddlePaddle 团队把它定位成能将 PDF 与影像转成结构化资料的 OCR toolkit 与 Document AI engine,输出可以是 JSON、Markdown,甚至 Word。这让它不只是影像转文字函式库,而是 RAG、文件问答与 Agent 工作流前面的资料整理层。
先讲结论:它解决的是「文件进入 LLM 前的最后一公里」
PaddleOCR 适合处理三种常见任务。第一种是一般 OCR,也就是从照片、扫描件或自然场景中找出文字并辨识内容。第二种是文件解析,除了字串之外,还要理解版面、表格、公式、图片和阅读顺序。第三种是视觉语言模型导向的文件理解,让复杂页面可以被整理成更接近人类阅读方式的 Markdown 或 JSON。
这三者的差异很重要。若需求只是辨识发票上的几个栏位,一个轻量 OCR pipeline 可能已经足够;若需求是让企业知识库回答「第二页表格中,去年第四季的毛利率是多少」,你就需要保留表格座标、栏位关系和跨页结构。PaddleOCR 的多层 pipeline 设计,让团队可以依任务选择,不必一开始就把最重的模型全部搬进服务。
PaddleOCR 的四层能力
1. PP-OCR:先把文字可靠地找出来
一般 OCR pipeline 由文件方向分类、文字影像去扭曲、文字行方向分类、文字侦测与文字辨识等模组组成。其中前几个模组可以依场景开关,真正的文字侦测与辨识则是核心路径。官方目前将 PP-OCRv6 列为预设模型系列,并提供 tiny、small、medium 等层级,让部署可以在边缘装置、一般 CPU 与伺服器之间取舍。
这个层级的输出适合搜寻索引、简单栏位撷取、相片文字辨识和批次数位化。如果资料本身是单栏、排版简单的影像,先从 PP-OCR 开始通常是最合理的工程选择。
2. PP-StructureV3:把版面变成可用的结构
文件问答真正困难的地方通常不是字被认错,而是字和字之间的关系被破坏。PP-StructureV3 的重点是文件版面解析,可以处理标题、段落、表格、公式、图片等元素,并提供更细的座标资讯。官方范例显示,它可以将结果储存成 JSON、Markdown 或 Word。
对 RAG 而言,这一层可以视为 ingestion pipeline 的核心。你可以先用 JSON 保留座标、类型与页码,再依检索需求产生 Markdown chunk。这比把所有文字直接串成一个长字串更容易做页码引用、表格重建、标题分层与错误追踪。
3. PaddleOCR-VL:处理复杂页面与多模态内容
当文件中有复杂图表、手写字、历史文件或表格跨页情况,单纯的侦测加辨识 pipeline 可能不够。PaddleOCR-VL 提供文件解析导向的 vision language model pipeline,能将输出整理成 JSON、Markdown 与 Word。官方文件也提供 restructure_pages,可在多页结果之间合并表格、重建多层标题与串接页面。
这个能力很适合接在企业文件汇入流程后面,但也代表更高的模型与硬体成本。它比较像「高品质文件解析服务」,不是每一张收据都需要启用的预设 OCR。
4. 多语、推论引擎与部署后端
PaddleOCR 不只提供 Python API。官方文件列出 PaddlePaddle、Transformers 与 ONNX Runtime 等推论方向,也提供 CPU、GPU 与多种 AI accelerator 的部署选项。一般文字辨识可从最小依赖开始,文件解析、资讯抽取、文件翻译与 doc2md 等能力则用 optional dependency group 个别安装。
这种设计的优点是可以把「功能选择」和「硬体选择」拆开。缺点是环境矩阵也会变得更复杂,尤其是 GPU、CUDA、PaddlePaddle、Transformers 和 FlashAttention 等依赖版本互相牵动时,不能只看一行 pip 指令就认定可以直接上线。
为什么它对 RAG 特别有用?
我会把 PaddleOCR 放在 RAG 的 ingestion 边界,而不是把它当成向量资料库的替代品。一个比较完整的流程可以拆成六步:先接收 PDF 或影像;再做方向与版面处理;接着辨识文字、表格、公式与图片;将结果保存为带有页码和元素类型的 JSON;依标题与段落产生 Markdown chunks;最后才交给 embedding、vector store 和 reranker。
这样的分层有三个实际好处。第一,OCR 错误可以追溯到原始页面与座标,而不是等到 LLM 回答错误才猜原因。第二,同一份解析结果可以同时服务关键字搜寻、向量检索、表格查询和人工预览。第三,当你替换 embedding model 或 LLM 时,不需要重新解析所有原始文件。
另一个常被忽略的好处是负责任的引用。若 chunk 保留页码、标题路径和表格位置,回答就能附上「第几页、哪个区块」的证据。这不会自动消除幻觉,但会让评估、除错与人工覆核有明确落点。
如何开始:先做最小可验证流程
官方安装文件把 paddleocr 核心套件和 optional capabilities 分开。基本 OCR 可以先安装:
python -m pip install paddleocr若要使用文件解析相关能力,官方列出的 dependency group 是 doc-parser;若需要把 Word、Excel 和 PowerPoint 转成 Markdown,则可考虑 doc2md;要一次安装完整能力才使用 all。实际推论前,还要依使用的后端安装 PaddlePaddle 或其他 inference engine。
最小的 Python OCR 范例如下,程式码采用官方文件目前的 pipeline API:
from paddleocr import PaddleOCR
ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)
result = ocr.predict("./document.png")
for res in result:
    res.print()
    res.save_to_img("output")
    res.save_to_json("output")
如果目标是文件结构而不是纯文字,可以改用 PP-StructureV3:
from paddleocr import PPStructureV3
pipeline = PPStructureV3()
output = pipeline.predict("./document.png")
for res in output:
    res.print()
    res.save_to_json(save_path="output")
    res.save_to_markdown(save_path="output")
    res.save_to_word(save_path="output")
若要快速试 PaddleOCR-VL,官方文件提供 CLI 与 Python API。以 Python API 为例:
from pathlib import Path
from paddleocr import PaddleOCRVL
output_dir = Path("./output")
output_dir.mkdir(parents=True, exist_ok=True)
pipeline = PaddleOCRVL()
output = pipeline.predict("./document.pdf")
for res in output:
    res.print()
    res.save_to_json(save_path=output_dir)
    res.save_to_markdown(save_path=output_dir)
第一次执行时要预留模型下载与初始化时间。官方也提醒,快速验证用的本地方法不一定符合生产环境对速度、记忆体与稳定性的要求;真正上线时,应把模型服务、并发控制、批次大小、超时与监控一起设计。
导入时最容易踩到的五个坑
坑一:把 OCR 结果直接当成干净资料
OCR 输出只是模型推论结果,不是事实资料。低解析度扫描、斜拍、印章、手写字、表格线和特殊字体都可能造成错误。导入后要建立抽样集,分开量测文字辨识、表格结构、栏位抽取和最终问答,不要只看一个总准确率。
坑二:所有文件都使用同一个 pipeline
一页收据、双栏研究报告、跨页财务表格和含图表的简报,根本不是同一种输入。可以先用文件分类器决定走 PP-OCR、PP-StructureV3 或 PaddleOCR-VL,并把高成本模型留给真正需要的页面。
坑三:忽略模型下载与硬体相容性
PaddleOCR 会依 pipeline 自动取得官方模型,但这不代表 production container 里可以无限制连外网。部署前应固定模型来源与版本,预先下载或建立快取,并确认 CPU、GPU、CUDA、PaddlePaddle 与推论引擎的组合。不要同时安装互斥的 CPU 与 GPU PaddlePaddle 套件。
坑四:只把 Markdown 丢进向量资料库
Markdown 很适合阅读与初步切 chunk,但 JSON 中的页码、元素类型、座标与表格资讯不应丢掉。建议把可检索文字和 provenance metadata 分开保存,让向量检索只负责找到候选内容,回答层再用 metadata 组合引用和页面预览。
坑五:用 benchmark 数字取代自己的验证
官方 README 和文件提供许多模型、速度与 benchmark 资讯,但它们会受到资料集、硬体、推论模式和前后处理方式影响。你的文件格式、语言和扫描品质可能完全不同。最可靠的做法仍是拿真实资料建立 golden set,并记录 latency、记忆体、失败率和人工修正成本。
我会怎么评估它是否适合团队?
若团队已经有 Python 服务、需要处理多语文件,而且 RAG 品质被 PDF 和扫描件拖累,PaddleOCR 值得先做一个小型 proof of concept。第一个 PoC 不要直接挑最难的全自动 Agent,而是选一个可量测的资料流,例如把一批供应商 PDF 转成带页码的 Markdown 和 JSON,再比较导入前后的检索命中率与人工查找时间。
如果需求是少量简单文字辨识,PaddleOCR 可能显得太重;如果团队没有能力处理模型服务、硬体相容性和文件品质治理,也不应只因为 GitHub 星数高就直接替换现有 SaaS。它的开源和可部署性是优势,但也意味着版本、模型、资源与监控责任要由使用者承担。
对 AI Chain 这类重视实作的团队,我会把它看成一个可组合的 document intelligence building block。它不会替你完成整个 RAG,也不会自动保证答案正确;它真正提供的是一条从非结构化文件到可被下游系统消费的资料管线。只要把这个边界定清楚,后面的 embedding、检索、引用和 Agent 工具才有稳定的地基。
结语:先修好输入,才有资格讨论模型
很多 RAG 专案把注意力放在换 embedding、调 chunk size 或比较不同 LLM,却没有先检查文件进入系统时是否已经失去结构。PaddleOCR 的意义在于提醒我们,Document AI 并不是 RAG 旁边的一个小工具,而是决定知识能不能被正确检索的前置工程。
我会建议从最小路径开始:先用 PP-OCR 建立可重现的文字辨识基线,再用 PP-StructureV3 加入版面和表格资讯,遇到复杂页面时才引入 PaddleOCR-VL。每一步都保留原始档、模型版本、页码、输出格式和评估结果。这样做看似慢,却比一开始把所有模型接上 Agent,再用几个错误答案追查整条链路可靠得多。
参考资料