RAG 不一定要向量资料库:PageIndex 如何让模型沿着文件树找答案
RAG 不一定要向量资料库:PageIndex 如何让模型沿着文件树找答案
我认为,RAG 系统最容易被忽略的问题,不是模型够不够大,而是「它到底怎么找到这段内容」。典型做法是把文件切成固定大小的 chunks,替每个 chunk 建立 embedding,再用向量相似度找出几段看起来相近的文字。这条路径成熟、容易理解,也很适合大量短文本;但当资料变成年度报告、法规、技术手册或研究论文时,固定切片常常会把上下文拆散。
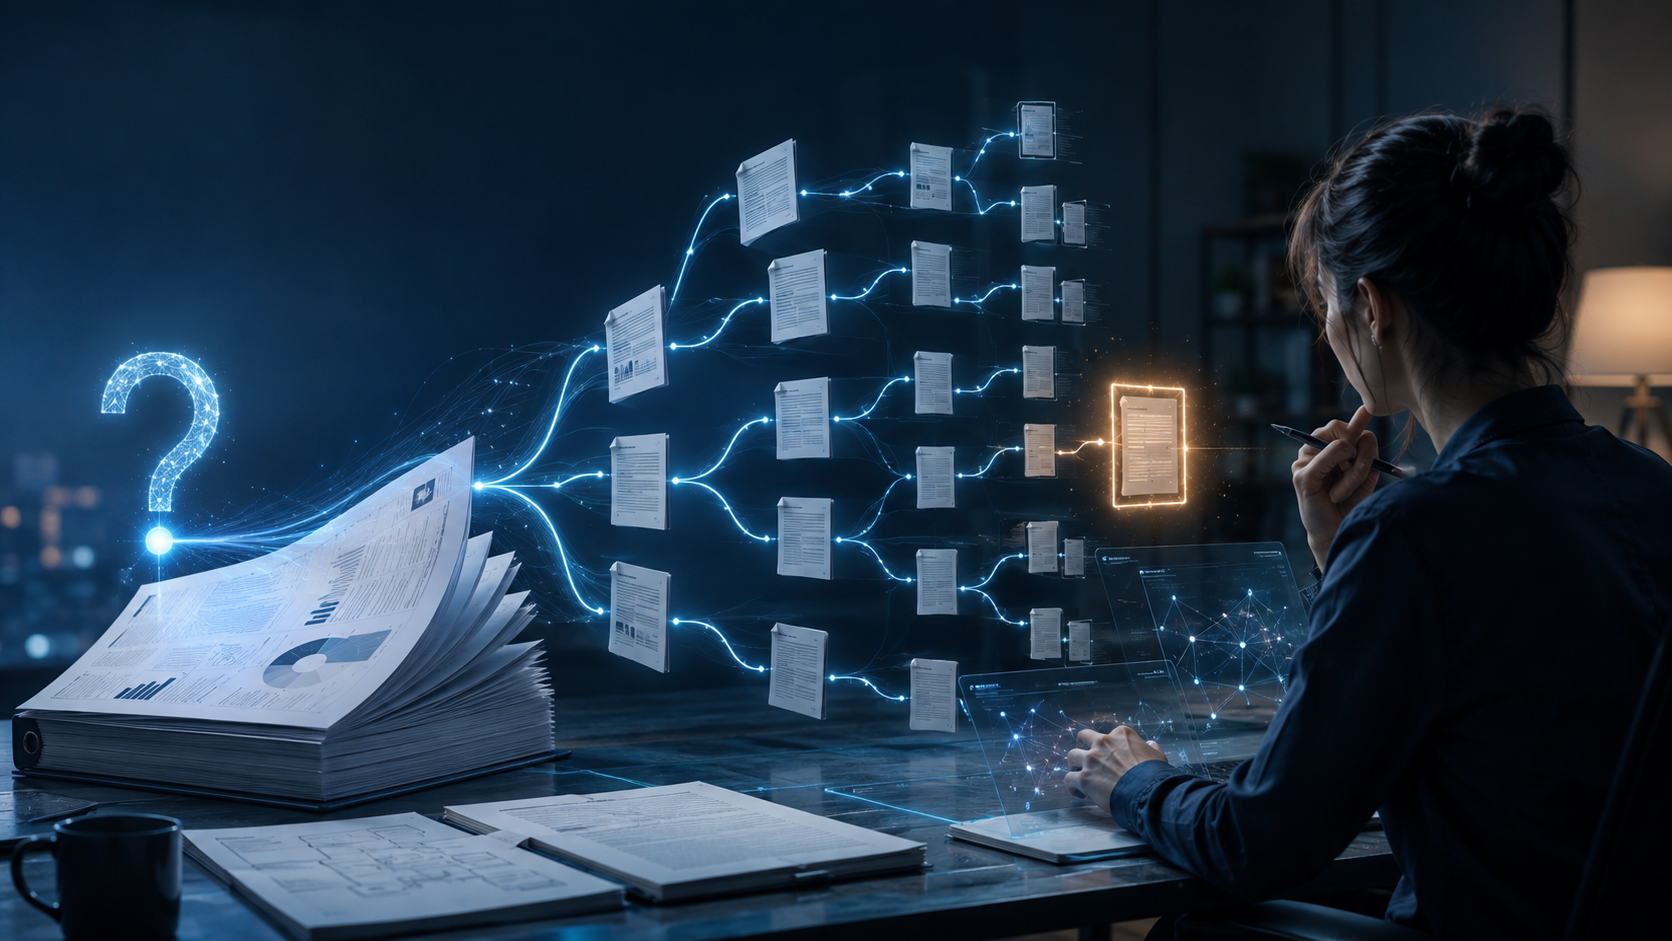
PageIndex 是 VectifyAI 开源的文件索引与推理式 RAG 专案。它的核心主张不是再做一个更快的向量搜寻,而是把文件转成阶层式 tree index,让 LLM 像人阅读长文件一样,沿着章节与子章节逐步判断应该查看哪里。这个方向值得注意,但也不能被简化成「向量资料库已经过时」:PageIndex 官方 README 明确把它定位成研究性、reasoning based 的 vectorless RAG 引擎,实际是否适合,仍取决于文件结构、查询型态、模型成本与可接受的延迟。
先讲结论:它解决的是「相关」不等于「相似」
向量 RAG 的优点是效率与规模。文件被转成向量之后,查询可以快速找到语意相近的片段;对 FAQ、客服纪录、产品描述与大量短文件,这通常是很实用的基线。不过,相似度只回答「这段文字和问题像不像」,不一定回答「这段文字在整份文件的脉络中是不是正确答案」。
例如,使用者问一份财报「某年度营业利益率是多少,以及这个数字在管理层讨论中如何解释」。答案可能分散在财务表格、注解与管理层评论。单独看某个 chunk,数字也许相似,但缺少章节关系、表格标题或前后文,就容易得到看似合理却不完整的回答。
PageIndex 的做法是先建立文件的阶层结构,再让模型在这棵树上进行检索。官方说明把流程拆成两步:第一步是 index,从文件产生 tree structure index;第二步是 retrieve,让 agent 透过 LLM reasoning 搜寻这棵树。这带来一个重要差异:检索单位不再是任意长度的文字片段,而是文件原本具有语义的章节、节点与页面范围。
我会把它理解成「把文件目录变成可推理的导航图」。模型不是只问哪一段文字最像,而是先判断问题应该落在哪个主题分支,再往下缩小范围,最后回到可追溯的页面或节点。这也是 PageIndex 强调 traceable 与 explainable retrieval 的原因。
PageIndex 的架构,和一般 RAG 差在哪里
1. Index:先建立阶层式文件树
PageIndex 不是把全文直接丢给聊天模型。它先分析文件的版面与结构,产生一个代表章节关系的树。对有清楚目录、章节标题、页码与段落层次的 PDF,这种索引方式可以保留「内容位于哪个脉络」这个资讯。
这和固定 chunking 的差别很实际。chunking 往往需要决定片段大小、overlap、分隔符号与 metadata;切得太小,答案被拆碎;切得太大,检索精准度与上下文成本又会上升。PageIndex 的官方定位是 no vector DB, no chunking,但这不表示它不需要任何资料转换,而是把前处理重心从「切成可嵌入的片段」移到「建立可导航的文件结构」。
2. Retrieve:沿着树做推理式搜寻
查询进来后,模型会在树上选择可能相关的分支,逐步读取节点,再把结果连回文件中的具体位置。当问题涉及多个章节或需要理解上下文时,这种 agentic search 有机会比只取相似 chunk 更自然。
但这里也有一个工程上的交换:推理式检索通常需要更多模型呼叫,延迟不会自动低于向量搜寻。PageIndex 的价值不是承诺每次查询都更快,而是把检索判断本身做得更接近长文件阅读。团队在评估时,应该同时测量答案正确性、引用可追溯性、每次查询成本与 P95 延迟,而不是只看 demo 是否能回答一个问题。
3. Chat:把检索结果交给问答介面
SDK 将索引与查询包装成 client。README 的 quickstart 示范了建立 PageIndexClient、提交 report.pdf、取得 doc_id,再以 client.chat 提问。这表示它不只是一组离线索引工具,也试图提供从文件送入到对话查询的完整入口。
更重要的是,PageIndex 的文件还列出 streaming、多文件搜寻、citations,以及把 PageIndex tools 整合进 OpenAI Agents SDK、Claude Agent SDK 或其他 agent framework 的方向。对已有 agent 平台的团队来说,它比较像一个可插入的文件推理工具,而不是要求整个应用程式改写成单一产品。
如何开始:先用一份文件验证,不要直接索引整个知识库
我建议把 PageIndex 当成一个需要验证的检索策略,而不是安装后立刻替换现有 RAG。官方 quickstart 的最小流程可以整理成以下几步。
第一步:准备 Python 环境与模型存取
官方 README 以 PyPI 套件作为入口:
pip install -U pageindex接着要准备可呼叫的 LLM API key,并选择建立索引与进行查询的模型。索引模型主要负责建立或整理树状结构;聊天模型负责理解问题、搜寻树并产生答案。官方建议索引模型可以使用较基本的模型,而查询模型应优先选择能力较好的模型,因为后者直接影响推理式检索品质。
这里的重点不是照抄某个模型名称,而是把两种成本拆开看。索引通常是一次性或低频工作,查询则可能是每天数千次的线上工作。把最强模型只用在需要推理的查询阶段,通常比所有步骤都使用同一个昂贵模型更容易控制预算。
第二步:建立 client 并提交一份 PDF
以下是官方 quickstart 的概念性入口,实际模型名称与 provider 设定应以目前文件为准:
import os
from pageindex import PageIndexClient
os.environ["OPENAI_API_KEY"] = "your-openai-key"
client = PageIndexClient(
    index="index-model",
    chat="chat-model",
)
doc_id = client.submit_document("report.pdf")["doc_id"]
answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
在正式环境中,不要把真正的 key 写死在程式码或 commit 里;应使用环境变数、secret manager 或部署平台的 secrets。提交文件后,先确认是否取得有效的 doc_id,再执行一个能对照原始 PDF 的问题。第一个测试最好不是开放式问题,而是答案位置明确、可以人工核对的数字、日期、条款或章节。
第三步:建立小型评测集
不要只问一题就下结论。我会从目标文件挑选十到二十个问题,分成三类:单一章节可以回答的问题、需要跨章节连结的问题,以及刻意测试相似但不相关内容的问题。每题记录标准答案、正确页面、是否需要引用、回答耗时与模型用量。
接着拿同一批问题跑现有的 vector RAG 与 PageIndex。评估结果至少要分开看:
- 找到正确内容的比例,而不是只看文字相似度。
- 回答是否保留必要的上下文与条件。
- 引用是否能回到正确页面或节点。
- 索引的初始成本,以及每次查询的 token 与延迟。
- 文件更新后,重建索引是否容易、是否会影响线上服务。
这个评测流程比单一 benchmark 数字更接近导入决策,因为企业文件的版面、语言、表格与权限逻辑往往和公开资料不同。
为什么长篇专业文件特别适合拿来测试
PageIndex 的定位很清楚:金融报告、法律文件、监管申报、技术手册、医学文献与学术教科书等长而复杂的专业文件,是它最有机会展现差异的场景。这些文件通常具有可利用的阶层结构,同一个名词又可能在不同章节扮演不同角色。
以法规为例,问题可能不是「哪一段提到某个词」,而是「在什么条件下,哪个例外条款优先适用」。以技术手册为例,某个参数的意义可能要和版本、平台、前置设定一起解读。如果只从相似度取回几段片段,模型还要自己猜这些段落在文件中的关系;如果索引保留了目录和节点脉络,模型至少多了一条可推理的导航路径。
不过,文件有结构不等于结构一定正确。扫描品质差、目录缺失、表格解析错误、跨页栏位或大量图片,都可能让树索引建立在不可靠的基础上。因此导入前应先抽样检查树状索引,不能把「有 tree」当成「理解了文件」。
成本、限制与容易误判的地方
它不是所有 RAG 的替代品
短文本、高频查询、需要毫秒级回应,或资料本身没有稳定阶层结构时,向量索引仍然可能是更直接的选择。PageIndex 的推理式搜寻引入了模型呼叫,查询成本和延迟都应该纳入设计。更合理的架构可能是混合策略:先用 metadata 或关键字做粗筛,再对少数长文件使用 tree reasoning,而不是全站每个查询都走同一条路。
索引费用不是零
官方 README 提供了本地索引成本与时间的估算,并提醒使用者先阅读文件、从小规模开始。即使一次索引的成本可以接受,企业仍要计入文件更新频率、重建策略、模型价格变动、失败重试与储存成本。尤其是每天变动的资料,若每次更新都要重建完整树,整体成本可能和原本的 embedding pipeline 不同。
推理能力不等于事实正确
PageIndex 强调 reasoning-based retrieval,但模型沿着错误分支推理时,仍可能产生幻觉或引用错误。检索可追溯性可以帮助审查,却不会自动取代资料治理、权限控管、版本管理与人工抽查。金融、法律、医疗等高风险情境,应要求答案附来源并设计拒答与人工覆核流程。
版本与 API 需要固定验证
开源 SDK 会持续演进。PageIndex 目前的 README 也提醒,local mode、Cloud、PageIndex Flash、多文件与 agent 整合等能力会随版本更新。文章中的安装命令只能作为起点,团队在导入时应锁定套件版本,阅读对应版本文件,并在 CI 中验证索引输出与查询结果,不要直接假设最新版本和旧 quickstart 完全相同。
隐私与资料边界要先谈清楚
如果文件包含个资、商业机密或受规范资料,首先要确认索引与查询会把哪些内容送到哪个模型 provider。local mode 可以让索引、检索与聊天在本机执行,但「本机执行」不代表所有模型都在本机;只要使用外部 LLM API,就要重新检查资料传输、保留期限与供应商条款。这一点比选择 vector 或 tree 更基本,也更不能省略。
我会如何决定是否导入
我的判断顺序会是先看文件,再看技术。若资料是大量短句、标准问答与明确 metadata,先把传统 vector RAG 做好,通常比较划算。若资料是数百页以上的专业文件,问题需要跨章节理解,且团队在意引用能否回到原始位置,PageIndex 就值得进入 A B test。
第二个判断是「错误的代价」。如果错误只会让使用者多点一次搜寻,较高的推理成本可能换来更好的体验;如果错误会造成合约、财务或医疗决策,则不能只用 demo 成功率判定,必须加上引用检查、权限、审批与 fallback。
第三个判断是团队能否维护评测。无论采用哪种 RAG,没有固定问题集、版本纪录和成本监控,最后都只是在凭感觉换元件。PageIndex 的真正价值,应该透过与既有方案的同资料、同问题、同模型条件比较来证明,而不是因为「不用向量资料库」这句话听起来新鲜就直接上线。
结语:把检索从相似度问题,重新变成阅读问题
PageIndex 提供了一个值得实验的观点:长文件问答的瓶颈,有时不是 embedding 不够好,而是系统没有保留文件原本的结构。用阶层式树索引搭配 LLM 推理,让检索更像人从目录找到章节,再回到页面确认内容。这种设计特别适合结构清楚、篇幅很长、需要上下文与来源追踪的专业文件。
我的建议不是全面抛弃向量 RAG,而是把 PageIndex 放到正确的位置:先挑一批高价值长文件,建立可核对的评测集,再比较答案品质、引用、成本、延迟与更新维护。若结果证明 tree reasoning 能降低关键错误,再用混合架构扩大;若文件结构不稳定或查询量太高,传统方法可能仍是更好的工程选择。
参考资料