让 LLM 读懂整个程式库:用 Repomix 建立可控、可压缩的程式码上下文
让 LLM 读懂整个程式库:用 Repomix 建立可控、可压缩的程式码上下文
AI 辅助开发最常见的问题,不是模型完全不会写程式,而是它只看得到你贴进对话框的那几个档案。当问题牵涉到设定、资料流、共用型别、测试与部署脚本时,零散的片段很容易让模型做出局部正确、整体错误的建议。
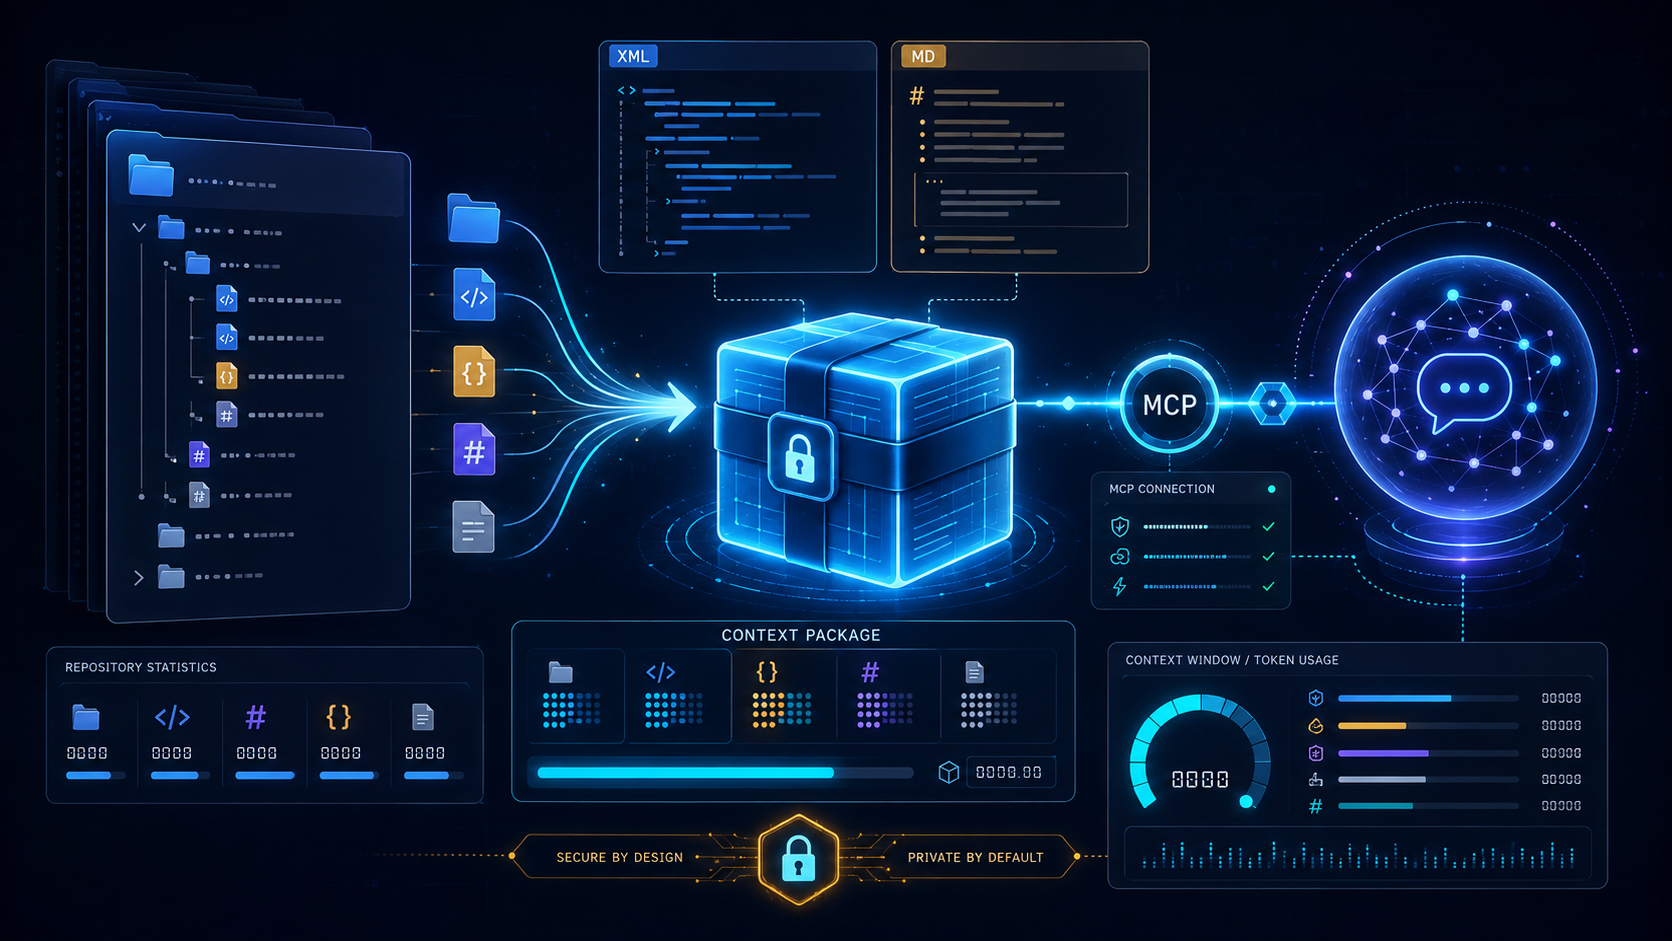
Repomix 的做法很直接:把一个程式库依照规则打包成单一、适合 AI 处理的档案,再交给 ChatGPT、Claude、Gemini 或其他工具分析。它不是另一个聊天机器人,而是 AI 程式码工作流里的「上下文准备层」。
截至 2026 年 8 月 20 日,GitHub 显示 Repomix 约有 2.8 万颗星,主要语言是 TypeScript,采 MIT License;官方最近一次 release 是 v1.18.0,且专案在 2026 年 8 月仍持续更新。这些数字会变动,本文的重点则放在它目前公开的 CLI、设定、压缩与 MCP 能力。
先理解它解决的问题:上下文不是越多越好
把整个程式库原封不动塞给模型,看起来像是「提供完整上下文」,实际上常常会遇到三个瓶颈:
1. 档案太多:node_modules、建置产物、快取、测试快照与产出档案会稀释真正重要的程式码。
1. token 预算有限:不同模型的 context window 不同,没有先估算就送出,可能在请求前被截断,或在模型内部失去重点。
1. 敏感资料不能外流:.env、测试凭证、私有设定或意外提交的 token,都不应因为「请 AI 帮忙看程式」而被一并分享。
Repomix 将这些事情集中在打包阶段处理:它会遵守 .gitignore、.ignore 与 .repomixignore,支援 token 统计,并以 Secretlint 做敏感资讯检查。这不代表输出就自动安全;安全检查是辅助,真正送出前仍要人工检查内容。
五分钟开始:先产生一份可检查的输出
在目标程式库根目录执行:
npx repomix@latest预设会产生 repomix-output.xml。如果你想固定版本、在 CI 或团队中重复使用,可以安装成专案开发依赖,或依照官方文件使用全域安装。第一次建议先不要急着把档案贴给模型,而是先检查输出:
# 查看输出档大小与内容
wc -c repomix-output.xml
less repomix-output.xml
对于远端公开储存库,也可以直接指定 GitHub URL 或 owner/repo:
repomix --remote yamadashy/repomix若要让结果可重现,使用固定的 branch、tag 或 commit,而不是永远追踪预设分支:
repomix --remote https://github.com/yamadashy/repomix --remote-branch 935b695这个细节对技术研究与 bug 回报很重要:模型分析的内容应该能对应到一个明确版本。
用 include 与 ignore 控制上下文边界
最实用的第一层控制是 glob pattern。假设你正在研究 TypeScript 的核心逻辑与文件,可以只打包相关档案:
repomix --include "src/**/*.ts,**/*.md"也可以在保留主要程式码的同时排除 log 与暂存目录:
repomix --ignore "**/*.log,tmp/"这里的观念不是「排除越多越好」,而是先定义问题的边界。例如:
- 做 API 重构:保留
src/、型别定义、路由、测试与相关文件。 - 查资料库问题:再加入 migration、schema 与 repository layer。
- 查部署问题:加入 Dockerfile、CI workflow、环境设定范例,但排除真正的 secret。
若需要更细的团队规则,可以执行 repomix --init 产生 repomix.config.json,把输出格式、档案筛选与安全选项纳入版本控制。官方也支援 TypeScript、JavaScript、JSON5 与 JSONC 等设定形式;使用可执行的 JavaScript/TypeScript 设定时,务必把它当成程式码审查,而不是单纯资料档。
不只是打包:四种输出与 token 视角
官方 CLI 支援 xml、markdown、json 与 plain 四种输出风格,预设是 XML。格式选择可以依工具调整:
repomix --style markdown -o context.md
repomix --style json -o context.json
repomix --style plain -o context.txt
XML 方便保留档案边界与结构;Markdown 适合人工阅读与贴到一般对话;JSON 适合由其他工具接续处理。不要把格式当成品质保证,真正重要的是档案选择与输出是否仍落在模型的 token 预算内。
Repomix 提供档案树与 token 计数,还可以用门槛只显示较大的档案:
repomix --token-count-tree
repomix --token-count-tree 1000
如果你要把 token 预算变成 CI 的硬性护栏,可以使用:
repomix --token-budget 120000官方说明指出,超过预算时输出仍会产生,但 CLI 会以非零 exit code 结束。这使它适合放进 agent workflow 或 CI:不是等模型回复「内容太长」,而是在送出前就让流程失败。
`--compress`:保留结构,缩小阅读负担
当程式库很大,但你目前只需要理解模组边界、类别、函式与介面时,可以使用 Tree-sitter 驱动的压缩:
repomix --compress它的目标不是把程式码「摘要成自然语言」,而是抽取重要的程式结构,移除部分实作细节,让模型先看懂骨架。这对第一轮架构盘点、寻找责任边界或规划重构很有用。
但压缩输出不适合取代所有原始码阅读。当模型要修改一个演算法、追查例外处理或确认竞态条件时,仍应重新打包相关档案的完整内容。比较稳定的策略是两阶段:
1. 先用 --compress 加 token tree,建立全局地图。
1. 找到疑似相关的模组,再用 --include 产生小范围、未压缩的上下文。
这比一次把整个 repository 原封不动交给模型更容易控制,也更容易在 code review 中说明模型是根据哪些档案做出判断。
接到 MCP:把一次性档案变成可查询工具
如果你的 AI 开发工具支援 Model Context Protocol,Repomix 可以直接以 MCP server 执行:
repomix --mcp官方文件列出的整合方式包含 VS Code、Cline、Cursor、Claude Desktop 与 Claude Code。以 Claude Code 为例:
claude mcp add repomix -- npx -y repomix --mcpMCP 的价值在于把「准备一份档案」转成「由助手按需打包与查询」。不过权限边界会因此变得更重要。官方特别提供 sandbox 模式:
repomix --mcp --sandbox
repomix --mcp --sandbox path/to/project
在 sandbox 下,档案工具会被限制在指定 workspace;绝对路径、~、..、越过 symlink 的路径等都会被拒绝。若 MCP server 可能被不受信任的 agent 或远端 client 使用,sandbox 应视为预设,而不是事后补救。
更重要的是:不要把 --mcp 当成「AI 可以安全读取整台主机」。它只解决工具协定与路径限制,不能替你决定哪些程式码可以送往第三方模型,也不能取代作业系统权限、网路隔离与 secret rotation。
安全检查的正确用法
Repomix 预设启用安全检查,会用 Secretlint 侦测可能包含凭证格式的档案,并在 CLI 输出警告。这是一道很有用的防线,但不应被误解为完整的资料防外泄方案。建议在送出前建立固定检查清单:
# 先用专案规则排除常见敏感档
repomix --ignore ".env,**/.env.*,**/secrets/**,**/*credential*"
# 再人工搜寻输出中的可疑栏位名称
rg -n "api[_-]?key|token|secret|password|private[_-]?key" repomix-output.xml
不要为了让流程成功而随意使用 --no-security-check。官方文件也提醒,关闭检查可能暴露敏感资讯;即使是测试档或范例凭证,也要确认它们不会与真实环境混淆。对远端 repository 也要特别注意:官方预设不载入远端储存库内的 repomix.config.*,因为 JavaScript/TypeScript 设定可能执行外部命令;只有在确认可信后,才考虑明确信任该设定。
我会怎么把它放进 AI 程式码流程
一个可维护的团队流程可以长这样:
问题定义
  ↓
决定上下文范围与版本
  ↓
repomix --include / --ignore
  ↓
检查安全警告与 token budget
  ↓
先以压缩输出做架构盘点
  ↓
针对相关模组产生完整上下文
  ↓
要求 AI 引用档案与行为依据
  ↓
人工 review、测试、再提交
这个流程的重点不是让模型「一次知道所有事情」,而是让上下文可以被重现、被缩小、被检查。每次送出的打包档最好记录 commit hash、使用的 include/ignore 规则与 token 统计;若模型提出修改,也要求它列出依据的档案,方便人类验证。
适合与不适合的场景
Repomix 适合:
- 想让模型快速建立陌生程式库的结构地图。
- 需要把多个相互依赖的档案交给 AI 做重构规划。
- 想在 CI 或 agent workflow 中对上下文大小设限。
- 已有 MCP 工具链,希望让程式码探索更接近按需查询。
它不会自动解决:
- 模型是否理解商业规则。
- 私有程式码能否合法送到某个模型供应商。
- 分散式系统的即时状态、外部资料库内容或执行期 bug。
- 没有测试、没有 review 的程式码品质问题。
换句话说,Repomix 是 context engineering 的基础工具,不是自动重构的保证书。它最有价值的地方,是把「我要给 AI 看哪些程式码」从临时复制贴上,提升成一个有规则、有边界、能在团队中重复的工程步骤。
结语:先把上下文工程化,再谈 AI 生成
AI 助手的输出品质,常常受限于输入上下文的品质。Repomix 用一个 CLI 将档案筛选、格式化、token 观察、结构压缩、安全警告与 MCP 整合串起来,让程式库阅读不必每次从手动贴档案开始。
如果你只想试一次,从 npx repomix@latest 开始;如果你要在团队或自动化流程中使用,则应进一步固定版本、审查 repomix.config.*、设计 ignore 规则、启用 token budget,并在 MCP 场景加入 sandbox。当上下文准备变成可验证的工程流程,AI 才比较可能从「看起来懂」走向「真的能被检查」。