从 RAG 到 Agent:Haystack 3.0 如何把 LLM 应用拆成可追踪的 Pipeline
从 RAG 到 Agent:Haystack 3.0 如何把 LLM 应用拆成可追踪的 Pipeline
如果你曾经把 RAG、工具呼叫、对话记忆和模型供应商整合在同一支程式里,应该很快会遇到一个问题:Demo 可以跑,系统却很难改。检索器换掉要改 prompt,模型换掉要重接流程,Agent 加上一个工具后又很难知道资料到底在哪一个节点被改写。
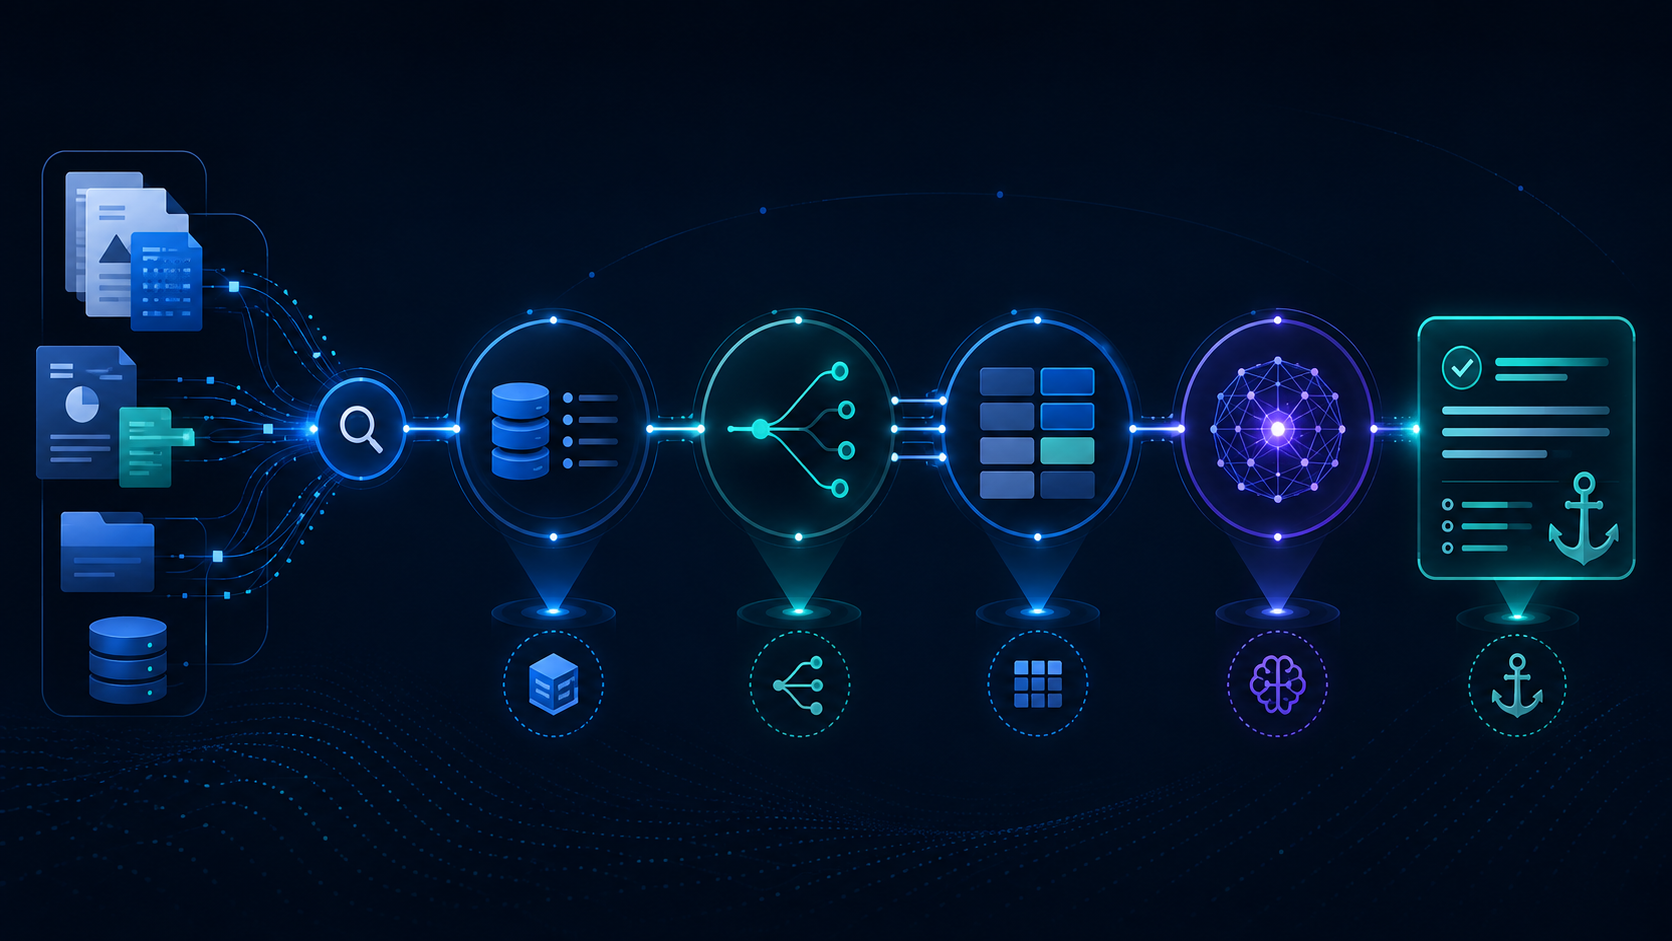
Haystack 提供另一种思路:把 LLM 应用拆成明确的元件,再用 Pipeline 将资料流连起来。它不是替你藏起所有细节的黑盒 Agent framework,而是让检索、路由、记忆、生成和工具呼叫都保持可组合、可替换、可观察。这正是它值得 AI 工程团队重新认识的地方。
本文以官方 repository、目前的 source code 与官方文件为主要依据,整理 Haystack 3.0 的核心设计,并用一个最小的 RAG Pipeline 说明它适合什么场景、怎么开始,以及哪些地方仍然需要工程判断。
先看专案:为什么现在值得关注?
截至 2026 年 8 月 21 日查证,deepset-ai/haystack 在 GitHub 拥有超过 26,000 颗 stars,最近一次 push 为 2026 年 8 月 20 日,采用 Apache License 2.0,主要语言是 Python。这不是只收集文章或 prompt 的资源清单,而是一个包含 pipeline runtime、components、dataclasses、serialization 与 generator 整合的实作型框架。
官方 README 将 Haystack 定位为「用 Python 建立 production-ready LLM applications 的开源 AI orchestration framework」。目前首页也特别标示 Haystack 3.0,并把 RAG、multimodal application、semantic search、question answering 和 autonomous agents 放在同一个可组合架构里。这个定位很适合写成工程实作文章:重点不只是「可以接模型」,而是如何把一个会持续变动的 AI 系统拆成可测试的资料流。
Haystack 的核心:元件不是函式呼叫,而是资料流节点
Haystack 的基本单位是 component。Prompt builder、retriever、ranker、generator、工具与自订逻辑,都可以成为 Pipeline 中的节点。每个节点有清楚的输入与输出,Pipeline 再负责验证连线、传递资料,以及在需要时执行分支、回圈与非同步流程。
这个设计带来三个工程上的好处:
- 替换成本低:可以把模型、retriever 或 prompt builder 换掉,而不必把整个应用改写成另一种抽象。
- 资料流可读:读 Pipeline 宣告,就能知道文件在哪里被检索、排序、放进 prompt,再送给模型。
- 测试边界清楚:可以先测每一个 component,再测元件之间的连线,而不是只对最后的文字答案做黑盒测试。
Haystack README 也列出 native async support、streaming、branches、loops 和 conditional logic。换句话说,Pipeline 并不只适合最直线的「输入问题 → 呼叫模型」流程;当产品需要加入 guardrail、工具路由或多阶段处理时,仍可维持同一套组合方式。
五分钟理解一个最小 RAG Pipeline
先安装套件:
pip install haystack-ai下面的程式直接依照 Haystack repository 内 PromptBuilder 的官方用法缩小而成。文件先以两个 Document 代表检索结果,接着由 PromptBuilder 把文件与问题渲染成 prompt,最后交给 OpenAIChatGenerator。真正的产品流程只需要把固定的 documents 换成 retriever 的输出即可。
from haystack import Document, Pipeline
from haystack.components.builders import PromptBuilder
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.utils import Secret
documents = [
    Document(content="Joe lives in Berlin"),
    Document(content="Joe is a software engineer"),
]
prompt_template = """
Given these documents, answer the question.
Documents:
{% for doc in documents %}
    {{ doc.content }}
{% endfor %}
Question: {{ query }}
Answer:
"""
pipeline = Pipeline()
pipeline.add_component(
    instance=PromptBuilder(template=prompt_template),
    name="prompt_builder",
)
pipeline.add_component(
    instance=OpenAIChatGenerator(
        api_key=Secret.from_env_var("OPENAI_API_KEY")
    ),
    name="llm",
)
pipeline.connect("prompt_builder", "llm")
result = pipeline.run({
    "prompt_builder": {
        "documents": documents,
        "query": "Where does Joe live?",
    }
})
print(result)这段程式的重点不是答案本身,而是两个连线边界。PromptBuilder 输出的是 prompt,OpenAIChatGenerator 接收这个输出并回传 replies。若下一步要换成另一个 generator,只要维持相容的输入输出契约;若要把文件来源换成 Elasticsearch、OpenSearch、Qdrant 或自订资料库,则把固定文件替换成对应 retriever 的输出。
另一个值得注意的细节是 PromptBuilder 使用 Jinja2 template。官方 source code 支援在每次 pipeline.run() 时覆写 template 或 template_variables,因此 prompt engineering 可以被当成输入变体测试,而不是散落在程式各处的字串拼接。这对做评测很重要:同一条资料流可以换 prompt、换模型参数,再比较输出。
从 RAG 延伸到 Agent:控制权留在 Pipeline
一般 RAG 的资料流可以画成:
问题 → Retriever → Ranker/Filter → PromptBuilder → Chat GeneratorAgent 则会多一个「决定下一步」的回圈:
问题 → Agent
         ├─ 呼叫搜寻工具 → 取得结果 → 再思考
         ├─ 呼叫内部 API → 取得资料 → 再思考
         └─ 完成回答
Haystack README 将 Agent 描述为可搭配 lifecycle hooks 的 production-oriented agent,并提到 before_llm、before_tool、on_exit 等 hook,以及 step_count、token_usage 和 tool calls 等资讯。这些能力的价值,在于 Agent 不再只是「把一串 tools 丢给模型」;团队可以在模型前后插入验证、纪录、成本控制与安全规则。
同一份 README 也提到 SkillToolset,让 skill description 只在需要时进入 context。这对工具数量会持续增加的系统很实用:不是每次都把所有工具的完整说明塞给模型,而是先以较小的索引做发现,再载入目前任务需要的能力。
但这不代表应该把所有流程都改成 Agent。若步骤固定,明确的 Pipeline 通常更容易测试、除错与估算成本;只有在下一步真的需要根据中间结果动态决定时,才值得引入 Agent 回圈。Haystack 的优势正是让这两种模式可以在同一个 component/pipeline 思维下共存。
模型与供应商解耦,并不等于完全没有差异
Haystack README 列出的整合范围包含 OpenAI、Mistral、Anthropic、Cohere、Hugging Face、Google、Azure OpenAI、AWS Bedrock 与 local models。这让应用层不必把供应商 SDK 的呼叫格式直接散落在业务程式里。
不过,抽象层只能处理共同介面,不能消除模型之间的行为差异。实作时仍要针对下列项目做验证:
1. chat message 与 tool calling 的格式是否一致。
1. streaming、token usage 与错误资讯是否能被现有 observability 接住。
1. context window、结构化输出和 retry 行为是否符合产品需求。
1. 不同模型在相同 retriever 与 prompt 下的答案品质和成本。
因此,Haystack 适合用来降低整合耦合,但不应被当成「换模型后不用重做评测」的保证。Pipeline 让比较变得容易,评测仍然是团队自己的责任。
一个适合团队落地的开发顺序
如果要用 Haystack 建立第一个可维护的 RAG 或 Agent 服务,可以采用以下顺序:
1. 先固定资料契约
先定义文件、查询、生成结果和错误的形状,再选 retriever。这能避免一开始就被某一家向量资料库或模型 SDK 绑住。
2. 先写直线 Pipeline
先完成「取得资料 → 组 prompt → 生成」的最小闭环,并把每个节点的输入输出记录下来。先确定资料真的有进到 prompt,再讨论 Agent。
3. 将 prompt 当成可替换输入
利用 PromptBuilder 的 template 与 template_variables,为 prompt 建立版本与评测案例。不要把 prompt 变更当成无法追踪的手动修改。
4. 最后才加入动态工具路由
当固定 Pipeline 已经无法处理需求,再加入 Agent、tools、hooks 和回圈。每一次工具呼叫都应记录名称、参数、耗时、结果大小与失败原因,否则出问题时只能猜模型做了什么。
Haystack 适合什么、不适合什么?
Haystack 适合以下情境:
- 需要把 RAG、Agent、semantic search 与生成整合在同一个 Python 服务中。
- 团队希望明确控制 retrieval、routing、memory 和 generation,而不是使用完全封装的黑盒流程。
- 需要替换模型供应商、资料来源或自订 component,并保留可测试的边界。
- 产品流程会从简单问答逐步演进成包含工具与多步骤决策的应用。
它不一定适合所有人。一次性的 prompt demo 用单纯 SDK 可能更快;如果团队没有维护 pipeline、评测与观测的打算,引入框架反而会增加概念负担。此外,Haystack 的「可组合」也意味着你需要自己做架构选择:文件切分、embedding、retriever、reranking、prompt、模型与安全策略都不会因为安装套件就自动正确。
结语:把「模型会回答」改成「系统可演进」
Haystack 最值得关注的地方,不是它又支援了多少模型,而是它把 LLM 应用重新拉回软体工程熟悉的问题:元件边界、资料契约、可替换性、测试与观测。
当 RAG 只是一个 notebook 时,任何框架都能让它跑起来;当它要变成有权限、有成本限制、会呼叫工具、需要持续评测的产品,透明的 Pipeline 与明确的 component interface 就会变得重要。Haystack 3.0 提供的是一个把这些需求放在同一个架构里处理的选项。
如果你的团队正在从「先做一个能回答的 Demo」走向「维护一个会持续改变的 AI 系统」,Haystack 值得拿一个真实的 RAG use case 试跑,而不是只看它的 star 数。
查证来源
- GitHub repository:deepset-ai/haystack
- 官方文件:Haystack Documentation
- 官方 quick start:Get Started Guide
- 官方 source code:PromptBuilder
- 官方 source code:OpenAIChatGenerator
本文的 GitHub stars、最近更新时间与版本相关资讯,以 2026 年 8 月 21 日查询 GitHub API 与 repository README 的结果为准;专案会持续更新,实际 API 请以官方文件为准。